Voxengo 插件3
- Voxengo
Peakbuster:多段瞬态增强效果器,具备自动瞬态增强、共振平滑和谐波增强能力。它通过智能算法分析音频动态,自动对瞬态(Attack)进行“恰到好处”的增益提升或削减,使处理后的声音保持自然。 - Voxengo
TransGainer:瞬态调整插件效果器。
- Voxengo
Crunchessor:多功能压缩器,有电子管一样的处理能力,声音更加温暖,且支持并行压缩,可以支持外部旁链,支持多通道压缩。 - Voxengo
Deconvolver:可处理并管理脉冲响应文件。支持多种采样率、量化精度、通道数。可做批量处理,内置波形发生器和去除直流电平工具,可做自动立体声标准化。 - Voxengo
Deft Compressor:压缩器,具有“细微”和“圆滑”的声音特点,能够增强音频的清晰度。其压缩器时间功能在起始和释放阶段近似于S-曲线,这种特性有助于产生“温暖”和“干净”的声音效果。 - Voxengo
Drumformer:专为打击乐器设计的动态处理插件,旨在优化鼓声的动态范围和清晰度。 - Voxengo
EBusLim:砖墙式峰值限制器和响度最大化插件。 - Voxengo
Elephant:母带限制器,可限制声音并最大化音量,而不会产生可听见的“模糊”和“抽吸”声音伪影。带有7个限制模式,自动启始(Attack)和释放(Release)。 - Voxengo
Marquis Compressor:压缩效果器,可以增加声音的谐波,提供丰富的声音效果。 - Voxengo
OVC-128:过采样削波插件,在最终峰值限制器之前进行硬限幅。 - Voxengo
Polysquasher 3:母带压缩器插件,仅需设置阈值和比率两个参数,操作简便。 - Voxengo
Soniformer:频谱母带动态处理器,将传入的声音信号分成 32 个频谱带。
Deft Compressor
Voxengo Deft Compressor:可以产出“纤细顺滑”质感的压缩效果,同时兼具语音清晰度提升的作用,这个效果得益于它在启动(attack)和释放(release)阶段都采用了类 S 曲线(Sigmoid曲线)的时序函数,这种设计让插件在绝大多数参数设置下都能呈现出温暖干净的听感。它还支持通过“Punch”参数平滑调整曲线形态,从 S 曲线逐步切换为更陡峭的 L 型曲线,灵活调整瞬态表现。
- 可切换类模拟电子管质感的“复古压缩模式”,支持在前馈、反馈两种压缩模式之间切换。
- 自带自动增益补偿、外部侧链输入、键信号滤波功能。
- 支持立体声与多通道处理、内部通道路由、通道分组,最高可开启 8 倍过采样。
- 采用 64 位浮点处理架构,附带预设管理器、撤销/重做历史、A/B对比、上下文提示信息功能,支持所有采样率,且处理延迟为零。
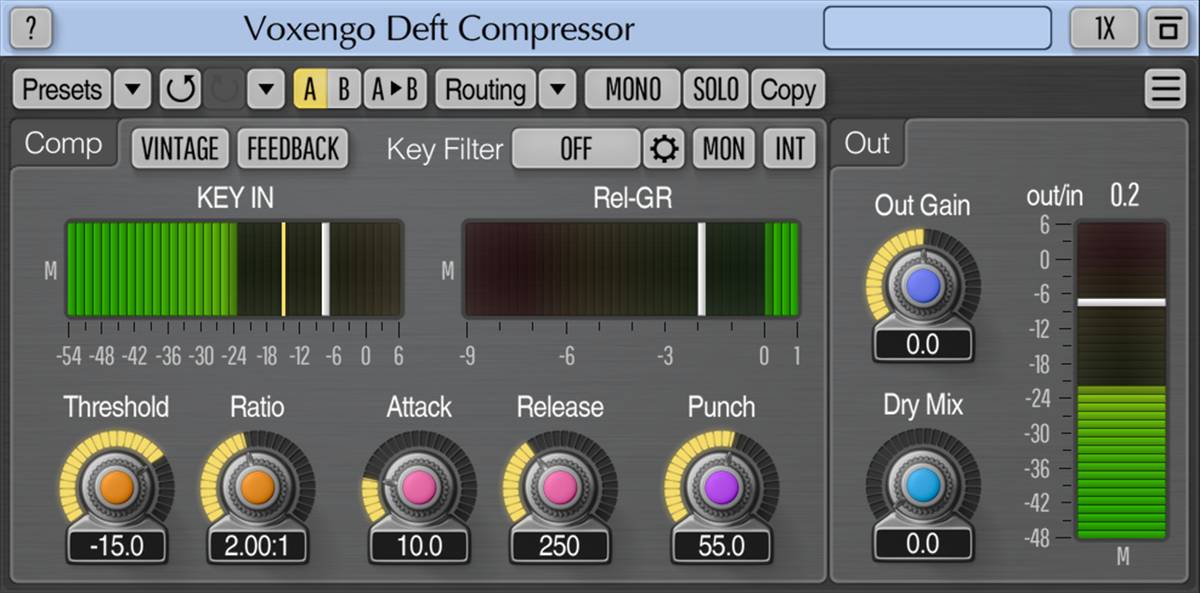
Dynamics 动态控制:该模块的参数用于调整压缩器的传递与时序特性:
- Threshold:阈值。以dB为单位,调整压缩器的拐点位置,拐点位置会同步反映在“In”输入电平表上。
- Ratio:压缩比。调整拐点的陡峭程度,以“输入输出比”形式呈现。
- Attack:启动时间。以毫秒(ms)为单位。定义压缩器的启动响应时长,高启动数值可用于强化音频瞬态,低至 0.01 毫秒的设置则可以实现对音频信号的重度“压碎”效果。
- Release:释放时间。以毫秒(ms)为单位。定义压缩器的增益恢复时长。
- 针对总线压缩无感知的使用需求,指南给出参考建议:若输入信号 RMS 电平为-24dBFS,可将 Threshold 设置为-35、Ratio 设置为 1.3:1。
- 该参数组合方案,也可通用在任何你希望压缩效果完全不突兀的场景中。
- Punch:瞬态强化。以百分比(%)为单位。调整瞬态强调效果的强度。
- 设置为 100 时效果达到最大,此时压缩器完全使用 S 曲线时序函数。
- 设置为 0 时,切换为响应更快的 L 曲线时序,该模式可能产生偏亮的染色效果,通常需要同步加大 Attack 和 Release 的参数数值。
- Feedback:切换开关,启用反馈压缩模式,相比前馈模式通常听感冲击力更强,凭借其自带的“预测式”运行特性,大多场景下可以得到更受控、波动更小的输出效果。
Key Filter 键信号滤波:该模块支持加载自带的键滤波器预设,也可以打开“Key Filter Mode Editor”窗口自定义键滤波器的频响形态:
- Mon:开关,可以启用滤波后键信号的监听功能。
- Int/Ext:开关可以切换键信号来源为内部输入信号、外部侧链信号,使用外部侧链信号需要提前配置对应的路由设置。
- 编辑滤波器形态时需要注意,键信号中响度更高的频段会被触发更强的压缩效果,编辑器内的“Key Gain”参数可以调整键信号的整体响度,用于修正侧链信号响度过高或过低的问题。
Vintage Compression 复古压缩模式:
- 启用该模式后,所有通道组的压缩行为会发生调整:在保留原有压缩听感的基础上新增柔和的饱和效果,此时你可以通过 Out Gain 旋钮将插件的输出推至 0dBFS 实现硬饱和,得到经典的“总线压缩器”效果,先调出冲击力十足的压缩音色,再削除过冲的峰值。该模式下信号的正负半波会被非对称限幅,因此不能用作最终输出的峰值限制。
- 使用上需要注意:压缩旋律人声、清音吉他,这类追求纯净质感的素材时需要谨慎启用该模式,饱和带来的不可避免的谐波染色在过载时会更加明显。
- 常规压缩模式更适合追求非自然强冲击力的现代俱乐部风格音乐,而复古模式适配所有希望得到更圆润冲击力的声学声源类音乐。
Out输出控制:
- Out Gain:以分贝(dB)为单位,调整插件的整体输出信号电平。
- Dry Mix:定义经过输出增益处理后,路由到输出端的原始未处理信号的占比,调高该参数可以降低整体失真,官方给出的搭配使用技巧是:先拉出足够高的失真量,再调整 Dry Mix 的数值,让处理后信号和干净原信号达到你需要的比例,该参数本质上实现了平行压缩功能。
Level Meters 电平表:插件搭载了三块带峰值电平指示的 RMS 电平表,所有电平表均使用分贝作为刻度:
- Key In:用于估算输入(键)信号的电平。
- Rel-GR:增益衰减表。显示增益衰减量,相对于 2秒平均增益衰减的实时变化,你可以通过“out/in”指示器查看全程的平均/固定增益变化。
- Out:用于显示插件的主输出电平。
常见问题解答:
- S 曲线时序函数的准确含义:S 曲线时序指启动和释放阶段的形态和 S 型(Sigmoid)曲线一致,给不同电平的直流信号做压缩就可以直观验证这个特性,这种曲线可以带来非常温暖的染色效果,没有生硬的边缘。同时长释放时间下的 S 曲线自带一小段“保持”延时,压缩器不会在这段时间内调整增益,这个特性让高频可以保持干净几乎无染色。S曲线天然具备类程序相关的释放特性,在短释放时间下压缩、或者处理频繁出现响亮瞬态的音频时,都不会产生明显的失真。
- 压缩器拐点特性:该压缩器的拐点,不属于覆盖几十dB范围的典型软拐点,也不属于硬拐点,处于两者之间但更偏向硬拐点。
- 极低启动时间无法完全压掉瞬态的问题:0.01毫秒这类极低的启动时间,理论上需要约 200kHz 的采样率才能让压缩器实现精确响应,如果你在 44.1kHz 采样率下使用这类设置,需要开启 4 倍甚至 8 倍过采样。同时 S 曲线的启动阶段不是瞬时完成的,在压缩器正式开始增益衰减之前会存在一小段保持时间,因此无法完全压制亚毫秒级的瞬态,你也可以将 Punch 参数调低至 70%以下,获得响应更瞬时的启动阶段来改善这个问题。
S 曲线(Sigmoid Curve)是一种 S 形平滑过渡曲线,其数学本质是 Sigmoid 函数。它的形状特点是:画出来就像一个拉长的"S"字。
- 起始阶段:变化缓慢(斜率小)。当信号刚超过阈值时,压缩器不会"猛地一下"全部压下来,而是温柔地开始介入,保留了瞬态的自然起始感。听感:压缩过程温暖、顺滑、不突兀,不会听到明显的"被压了一下"的机械感。
- 中间阶段:变化迅速(斜率大)。进入稳定压缩后,压缩量快速达到设定值。
- 结束阶段:变化再次放缓(斜率小)。当压缩即将完全释放时,恢复过程逐渐变慢,不会突然"弹开"。听感:恢复过程圆润、无缝衔接,背景不会突然"跳"一下。
在 Deft Compressor 中的实际表现:
- S 曲线定时函数是 Deft Compressor 的核心特色,攻击和释放阶段均采用 S 形曲线。这使得压缩听起来温暖、干净,同时保持高频清晰度。
- 当 Punch 降至 70%以下时,S 曲线效果减弱,定时函数逐渐偏向更快的 L 曲线。
- 极低 Attack 时间(如 0.01ms)时:S 曲线攻击阶段存在固有微小保持时间,无法完全抑制亚毫秒瞬态——这是 S 曲线数学特性的固有限制,并非设计缺陷。
一句话总结:S 曲线定时函数就是让压缩器的 Attack 和 Release 过程从"机械匀速"变为"先慢-再快-后慢"的自然 S 形过渡,使压缩听起来更温暖、顺滑、不突兀,是 Deft Compressor 获得其标志性"纤薄顺滑"音色的核心技术之一。
S 曲线(Sigmoid Curve)是一种 S 形平滑过渡曲线,其数学本质是 Sigmoid 函数。它的形状特点是:画出来就像一个拉长的"S"字。
- 起始阶段:变化缓慢(斜率小)。当信号刚超过阈值时,压缩器不会"猛地一下"全部压下来,而是温柔地开始介入,保留了瞬态的自然起始感。听感:压缩过程温暖、顺滑、不突兀,不会听到明显的"被压了一下"的机械感。
- 中间阶段:变化迅速(斜率大)。进入稳定压缩后,压缩量快速达到设定值。
- 结束阶段:变化再次放缓(斜率小)。当压缩即将完全释放时,恢复过程逐渐变慢,不会突然"弹开"。听感:恢复过程圆润、无缝衔接,背景不会突然"跳"一下。
在 Deft Compressor 中,Punch 参数允许你在两种定时函数之间切换,而线性定时函数是压缩器领域最基础、最原始的响应方式。
| 对比项 | S 曲线(Punch = 100%) | L 曲线(Punch = 0%) | 线性定时函数 |
|---|---|---|---|
| 曲线形状 | S 形(Sigmoid):起始缓→中间快→末端缓 | L 形(对数/指数):起始极快→末端缓慢微调 | 直线:匀速变化,斜率恒定 |
| Attack 响应 | 缓慢启动,平滑介入 | 快速启动,更直接 | 匀速推进,无快慢变化 |
| Release 响应 | 末端放缓,自然恢复 | 快速释放,更干脆 | 匀速释放,无快慢变化 |
| 瞬态处理 | 保留更多瞬态细节,瞬态不被突兀压制 | 瞬态被较快压制,但比线性更自然 | 瞬态被匀速压制,容易产生可闻的"咔哒"伪影 |
| 瞬态保留能力 | 最强(起始缓慢介入,保护原始瞬态) | 中等(快速介入,部分压制瞬态) | 最弱(匀速压制,瞬态被均匀削弱) |
| 听感自然度 | ★★★★★(最自然) | ★★★★☆(较自然) | ★★☆☆☆(最机械) |
| 音色特点 | 温暖、顺滑、音乐性强 | 快速、直接、可能更亮 | 机械、生硬、有"泵感" |
| 适用场景 | 人声、总线、需要"隐形"压缩 | 鼓、打击乐、需要快速响应 | 特殊效果(如明显的泵感节奏)、工业/实验音乐 |
| 潜在问题 | 极低 Attack 时固有微小保持时间 | 可能产生过亮/刺耳的音色 | 压缩过程最可闻,容易产生不自然的抽吸效应 |
| 抽吸效应(Pumping) | 最弱(Release 末端放缓,消除突兀感) | 较弱(快速释放但末端有微调) | 最强(匀速释放产生明显的"嗡-嗡"呼吸感) |
- S 曲线:像汽车踩油门的"舒适模式":起步缓慢平顺,中间加速有力,接近目标时轻柔收尾。
Peakbuster
Voxengo Peakbuster:基于高级自动算法的多频段瞬态增强器。它集成了瞬态(起音阶段,Attack-phase)提升、共振平滑和谐波增强三大核心功能。
- 适合场景:
- 整体母带:它最大的特点是即使使其在全频段的总线上也能听起来很自然,适合用于整体提升混音的清晰度和活力。
- 鼓组(Drums):在 M1 模式下,增强军鼓和底鼓的瞬态,让鼓组听起来更有力、更“跳”出来。
- 贝斯(Bass):使用 FX1 模式,可以让贝斯的泛音更丰富,在小音箱上也能听得更清楚。
- 声音修饰:文档特别提到它能提供“超越电子管温暖感”的独特谐波染色。
- 人声场景:
- 让人声“站出来”:
- 场景:人声在混音中感觉被乐器盖住,或者听起来有些“扁”。
- 操作:使用 FX1 模式。这个模式会提升人声中微弱的声音(quieter)的频谱部分,特别是高频泛音,让人声的质感瞬间变得丰满、清晰,轻松地从混音中剥离出来,变得非常有存在感。
- 人声的“抛光”处理:
- 场景:这是处理主唱人声的“终极方案”。你既想消除录音中的瑕疵和刺耳感,又不想让人声失去原有的力量和冲击力。
- 操作:在人声轨道上串联两个 Peakbuster。
- 第一个插件设为 M3 模式,力度稍大,负责“打扫卫生”,把粗糙的地方磨平。
- 第二个插件设为 M1 模式,力度适中,负责“上妆”,把人声的活力和穿透力找回来。
- 效果:这种处理后的人声,听起来会有一种“超越电子管温暖感”的独特模拟味,既平滑又充满能量。这种组合即可去除“粗糙感”,同时有完美保留甚至增强声音的冲击力(Punch)。
- 处理人声瞬态:
- 不能去除齿音:无法“精准剔除”齿音,但它能“物理磨平”齿音的尖锐棱角。
- 专业去齿音(De-esser):它的逻辑是:“我不管你是不是瞬态,只要你在 6000Hz 附近突然冒出来,我就把你这个频段的音量精准拉低。”它是基于特定频率进行定点清除的。
- 瞬态雕塑家(Peakbuster):它的逻辑是:“我发现这里有个能量突然爆发的瞬态(不管是低频的‘咚’还是高频的‘呲’),我要改变它的形状(Snap/Body)并给它加上谐波染色。”它是基于波形的时间形态进行整体塑形的。
- 两者区别:Peakbuster 解决的是齿音的“硬”和“刺”(瞬态冲击力),而专业的 De-esser 解决的是齿音的“响”和“多”(特定频率的能量)。
- 处理流程:但如果齿音非常突出,先用 De-esser 精准把“呲呲”声的音量拉下来,再用 Peakbuster 去美化整体的瞬态质感。
- 激昂/紧张人声:这类人声自带极强瞬态,容易导致听觉疲劳或刺耳。此时非常适合使用 M3 模式,适当调高 FX Hi,将这些过于尖锐、密集的瞬态“磨平”,让人声在保持力度的同时不显得噪杂。
- 轻柔/舒缓人声:这类人声本身瞬态极弱,如果使用 M3 模式,会让声音彻底失去轮廓。反而可以尝试 M1 模式,适度增加 Snap Time,为过于绵软的声音补充一点清晰的“字头”,提升可懂度。

Peakbuster 提供了三种截然不同的处理模式,以应对不同的音频需求:
- M1 模式:瞬态增强(Transient Boosting)
- 核心功能:专门用于增强声音的起动阶段(Attack-phase),提升起音的清晰度与力度。
- 工作原理:算法会快速识别并放大每个频段内的初始瞬态信号。通过调整 Snap Time 和 Body Time,可以精准控制增强的爆发力和持续时间。
- 听感特征:声音变得更加靠前、清晰、充满活力。它能让人声的唇齿开合声、呼吸声更加明显。
- 适用场景:鼓组(增加打击感)。原声乐器(增加空气感和细节)。需要增加活力的人声。
- 当人声在混音中被伴奏淹没,缺乏穿透力时,用 M1 提亮起音点,使其“脱颖而出”。
- 在使用了 M3 模式打磨后,如果声音显得过于平淡死板,可以用 M1 重新找回活力。
- M3 模式:瞬态衰减/共振平滑器(Transient Reduction & Resonance Smoothing)
- 核心功能:作为一个极其透明的“去刺耳(Deharsher)”、“平滑器(Smoother)”,精准削减突兀的瞬态尖峰和不自然的共振。
- 工作原理:与 M1 反向操作。它会智能地压低那些超出自然动态范围的高频摩擦声或生硬的数字瞬态,同时配合较高的 Trim 值激发内部的谐波染色机制,填补被削弱后留下的空洞。
- 听感特征:声音变得圆润、柔和、厚实。原本扎耳朵的尖锐感和冷硬感被磨平,获得类似模拟设备的温暖质感。
- 副作用:如果单独使用,可能会削弱声音的“冲击力(Punch)”,让声音变得软绵绵。
- 人声场景:修复电子合成男声的“冷硬”与机械感。处理录音环境不佳导致的粗糙嗓音或爆破音。压制特定辅音产生的刺耳高频气声和齿音。
- M3+模式:是 M3 模式的高级版或“带谐波补偿版”。
- 核心功能:M3+是 M3 模式的增强形态。它在保持对高频瞬态(Attack)和刺耳共振(Resonances)进行强力抑制的基础上,引入了更深层的谐波染色与质感补偿算法。
- 听感特征:
- 保留高级感的光泽:在磨平数字合成声中生硬的高频刺耳声的同时,声音不会变得发暗或发闷,而是保留了一种圆润、通透的“空气感”。
- 更强烈的厚度补偿:对于缺乏胸腔共鸣的合成男声,M3+能更好地填补因削减高频而产生的听觉空洞,让声音听起来肉感更强、更贴耳。
- 区别:
- 如果你觉得声音太干太脆,选 M3;如果你想要在削减的同时保留一点‘高级感’的光泽,选 M3+。
- 如果说 M3 是温和的“去刺器”,那么 M3+就是带有“质感重塑”功能的精密手术刀。它适合在标准 M3 模式无法完全解决素材的生硬与粗糙,或者在削减后导致声音失去生命力时,作为提升音色高级感的终极手段。
- 适合场景:专为处理带有强烈数字缺陷、极度粗糙或需要极致顺滑质感的音频素材而设计。
- 重度修复电子合成声(去数字味与金属感):针对带有强烈数字感、金属质感或高频“刮擦”声的电子合成人声,M3+是终极的修复工具。它不仅能精准削平那些扎耳朵的数字瞬态尖峰,还能通过内部的谐波补偿机制,有效填补因高频削减而产生的听觉空洞,将原本干瘪、冷硬的机械音转化为圆润、贴耳且富有高级感的磁性人声。
- 打击乐的高阶柔化(瞬态重塑与光泽保留):当镲片、沙锤等打击乐的瞬态过强,导致整体混音听感失衡或过于刺耳时,M3+能发挥“智能抛光”的作用。它在大幅度削减破坏性高频瞬态的同时,能保留乐器应有的空气感与光泽度,使打击乐在听感上更加融合、细腻,既去除了攻击性,又不会让声音变得发闷或失去活力。
- FX1 模式:频谱压缩器/特殊效果(Spectral Compressor / Special FX)
- 核心功能:它超越了单纯的音量动态控制,是在频率维度上对声音的能量分布进行重塑与平衡。
- 工作原理:作为一种独特的变换效果,FX1 能够智能地提升声音中较弱的频谱细节,同时控制过强的部分,使得整体频谱变得更加紧凑、饱满。
- 听感特征:增加声音的密度与融合度,使单轨素材听起来更加一体化、立体,不容易被混音中的其他乐器掩盖。
- 激进的音色改变:它本质上是一种“频谱压缩”,但它不是为了平滑,而是为了增加临场感和侵略性。
- 警告:在全频段混音(Full Mix)中使用可能会导致听觉疲劳(Fatiguing),因为它会把背景噪音和微小的细节都拉出来。
- 适用场景:Bass(贝斯):让贝斯的高频泛音凸显,更容易在混音中被听到。Vocals(人声):让主唱声音极具穿透力。需要特殊音效的合成器音色。
- 人声场景:打造极具贴耳感的主唱(Vocals),让人声的每一个咬字和泛音都清晰地悬浮在伴奏之上。修饰那些单薄、干瘪的数字合成音色,赋予其更强的存在感。
Dynamics(动态)面板:
- Trim:驱动效果强度,具备自动增益补充功能。
- 电平依赖:这种算法对输入进来的信号大小非常敏感。当你调大 Trim 时,你实际上是往算法引擎里推入了更强的信号。
- 处理效果:信号越强->算法处理越剧烈->谐波失真越多,瞬态塑形效果越明显。信号越弱->算法处理越轻微->声音越干净,效果越不明显。
- 内部机制自动“补偿输出”(保持音量一致):
- 原理:当你改变 Trim 时,插件会尝试计算处理后的信号电平,并进行反向调整,试图让你听到的整体响度保持相对稳定(或者符合预期的曲线)。
- 结果:你调大 Trim,虽然失真变多了,但音量不会像开了失真踏板那样突然爆表,而是维持在一个相对可控的范围内,只是声音变得更“实”、更“满”了。
- M1/FX1/M3 选择器:切换三种处理模式。M1:瞬态增强(标准);FX1:频谱压缩(特殊效果);M3:瞬态削减(平滑/去齿音)。
- FX Lo:低频效果强度。
- 功能定义:控制效果在低频范围(如底鼓、贝斯等)内的作用强度。
- 调节逻辑:增加 FX Lo 的值,意味着你希望低频部分的瞬态(如底鼓的冲击感)得到更明显的增强(在 M1 模式下)或削减(在 M3 模式下)。
- 数值调高:会让低频听起来更厚实、更有“拳击感”(Punch),但若过高可能会导致低频变得浑浊或失去控制。
- 数值调低:会让低频保持原有的动态,避免过度处理导致的相位问题或低频松散。
- 配合 M1 模式:如果你希望增强军鼓或贝斯的冲击力,可以适当调高 FX Lo。
- 配合 M3 模式:如果人声或吉他录音中低频共振(如喷麦声)过多,可以调高 FX Lo 来专门平滑这些低频的突兀感。
- FX Hi:高频效果强度。
- 功能定义:控制效果在高频范围(如镲片、人声齿音、泛音等)内的作用强度。
- 调节逻辑:增加 FX Hi 的值,意味着你希望高频部分的细节(如清脆的瞬态或刺耳的谐波)得到更明显的处理。
- 数值调高:会让声音的高频泛音更加丰富,增加“空气感”和清晰度(在 M1 或 FX1 模式下),或者更有效地去除刺耳的齿音(在 M3 模式下)。
- 数值调低:会保护高频免受处理,适合那些高频已经很完美、不需要额外修饰的音源。
- 配合 FX1 模式:这是让人声“站出来”的关键。调高 FX Hi 可以显著提升人声的高频泛音,使其在混音中更加突出和清晰。
- 配合 M3 模式:如果人声齿音过重,调高 FX Hi 可以专门针对高频的刺耳部分进行平滑处理。
- R(Residue):监听开关。
- 功能:开启后,你听到的将是输出信号与输入信号的差值(即插件所做的“加法”或“减法”)。
- 用途:这是一个非常强大的调试工具,能让你直观地听到插件到底增强了或削弱了哪些频率,从而辅助你调整 Trim 和 FX 参数。
- 应用:如果你在处理人声刺耳瞬态时打开 R 开关,你会清晰地听到那些尖锐的“呲呲”声、过激的刺耳声被单独剥离出来。这直观地证明了 Peakbuster 正在精准地“抓住”并“移除”这些刺耳的瞬态成分。
Envelope(包络)面板
- Bands:设置处理频段数量,影响整体“音色着色”和 CPU 占用率。数值越大,插件对声音的切割越精细;数值越小,处理就越整体、越连贯。
- 使用小数值(如 3 ~ 10):当需要对声音进行整体、宏观的塑形,或者追求连贯的模拟染色感时,适合使用小数值。
- 追求整体“胶水感”与模拟味:当 Bands 设置为较小的数值时,Peakbuster 会将音频划分为几个宽泛的频段进行处理。这就像给声音罩上一层统一的“滤镜”。在这种状态下,它的谐波染色和动态塑形是相对连贯的,非常适合用来给整体混音(Master Bus)或单个乐器增加“胶水感”,让声音听起来更像一个整体,带有浓郁的模拟设备质感。
- 避免相位失真与保持自然:分频处理不可避免地会带来轻微的相位偏移。使用较小的 Bands 值,能最大程度地保留原始声音的相位一致性,让瞬态听起来更自然、更直接,不会因为过度精细的切割而显得“支离破碎”。
- 节省 CPU 资源:更少的频段意味着更低的运算量。在轨道较多、工程较大的情况下,适当减小 Bands 数值可以减轻电脑的负担。
- 使用大数值(如 15 ~ 30):当需要对声音进行精细化的外科手术式处理,或者解决特定频段的动态问题时,适合使用大数值。
- 精准的频段独立控制:这是多频段处理的核心优势。当你将 Bands 调大(例如接近 30),你可以极度精准地控制某个特定频段的动态表现。实战举例:处理人声时,你可能只想压制人声中某个极其刺耳的特定高频共振峰(比如 6kHz 附近的一小段),但同时希望完全保留 5kHz 和 7kHz 的空气感与清晰度。调大 Bands 就能实现这种“只打蚊子,不伤皮肤”的精准效果。
- 解决特定频段的共振与浑浊:如果某个乐器的低频(如贝斯的 100Hz 附近)和中高频(如吉他的 2kHz 附近)同时存在动态过大的问题,使用多频段可以让 Peakbuster 同时在两个互不干扰的狭窄区域进行瞬态抑制,而不会误伤其他正常的频段。
- 获取更复杂的谐波纹理:不同的频段在独立产生谐波失真后,再重新组合在一起,会形成一种比单频段处理更复杂、更有层次感的音色纹理。这种特性在制作一些特殊音效或极具个性的电子音色时非常有用。
- 使用小数值(如 3 ~ 10):当需要对声音进行整体、宏观的塑形,或者追求连贯的模拟染色感时,适合使用小数值。
- Snap Time:调整瞬态“爆发”阶段的持续时间(Attack 的起始时间)。数值越小,瞬态越“脆”、越“快”,但谐波染色会越强;数值越大,效果越平缓。
- M1 模式下:用于瞬态增强。决定了增强动作的持续时间。调小数值,会让声音的起音部分更突出、更短促有力。
- M3 模式下:用于瞬态衰减。决定了衰减动作的持续时间。调小数值,衰减动作会非常迅速、短促。它会非常快地抓住并压制住最尖锐的瞬态峰值。过快的动作可能会带来更强的谐波染色,处理痕迹可能更明显。
- Body Time:调整瞬态“主体”阶段的持续时间(Attack 的主体时间),值越大,瞬态的“主体”越响亮,会牺牲一部分“脆度”(Snap)。这意味着声音的“肉感”或“厚度”会增加,但起音的锐利度会降低。
- M1 模式下:决定了增强后的瞬态主体持续多久。调高数值会让声音听起来更厚实,但可能会减少那种“短促有力”的打击感。
- M3 模式下:控制平滑处理中主体部分的时长。
Out(输出)面板
- Out Gain:控制插件的总输出电平。
- 电平表动态可在插件的设置窗口中调整。
谐波染色
Peakbuster 的“谐波染色”并非产生偶次或奇次谐波,而是由于算法非线性处理方式产生。
- 谐波失真度:约为 0.03%- 0.07%。这是一个“恰到好处的染色数值”。它不是为了高保真透明传输设计的,而是专门为了利用这点失真来增加声音的质感和存在感。
- 非线性失真:它会实时分析音频的波形,并根据 Snap Time、Body Time、FX Lo、FX Hi 等参数,有选择性地“塑造”声音的 Attack 部分,使其形状发生改变,而产生的非线性。
- 染色的特点:超越电子管温暖感。
- 不仅仅是“暖”:传统的电子管染色通常是指添加低频的厚重感和柔和的偶次谐波。
- 动态的“活”感:其染色是跟随音乐动态变化的。它不是静态的背景噪音或失真,而是一种“流体(Fluid)”的感觉。算法反应极快,使得声音在被修饰的同时,依然保持鲜活和动态,而不是被压平。
- 控制谐波染色参数:
- Snap Time:抓取时间。最强控制项。值越小,染色越强(更脆、更刺耳/有个性);值越大,染色越弱(更平滑、更透明)。
- Trim:偏置增益。微调味精。为了找到算法的“甜点(Sweet Spot)”。调整 Trim 可以改变算法对不同电平信号的反应,从而改变染色的质感。
- Bands:频段数。色彩浓淡。频段数越多,处理越精细,这会影响“整体染色”,通常频段多会带来更复杂的染色纹理。
插件预设
M1 模式(瞬态增强):这类预设主要用于增加声音的清晰度、冲击力和活力。
- Default(默认):
- 设置:工作模式:M1;Trim:0 dB;FX Lo:50;FX Hi:50;Bands:15;Snap Time:40;Body Time:80;Out Gain:0 dB。
- 特点:这是一个非常均衡的起点设置。中等的 FX Lo 和 FX Hi(均为50),意味着它会温和地增强整个频率范围的瞬态。
- 场景:通用场景。适合初学者或作为基础处理,不会过分强调某频段,让整体声音更“活”。适用于任何需要轻微“提神”但不想过分强调低频或高频的素材。
- Fine Highs(精细高音):
- 设置:工作模式:M1;Trim:11.1 dB;FX Lo:35.3;FX Hi:81.9;Bands:14;Snap Time:38.2;Body Time:106;Out Gain:0 dB。
- 特点:此预设大幅提升了高频(FX Hi:81.9)的瞬态,并配合较高的 Trim(11.1 dB),专门针对高音乐器的细节和空气感进行增强。
- 场景:适用于镲片、打击乐器、清音吉他、人声气口。旨在增加高频的空气感和光泽度,让声音听起来更细腻、不沉闷。
- Massive Bass Drum(强劲底鼓):
- 设置:工作模式:M1;Trim:8.6 dB;FX Lo:58.8;FX Hi:44.1;Bands:22;Snap Time:31.1;Body Time:72.1;Out Gain:0 dB。
- 特点:低频强化(FX Lo:58.8 > FX Hi:44.1),并使用了较多的处理频段(Bands:22),这有助于精确塑造底鼓的冲击力和低频特征。
- 场景:底鼓、贝斯。增加低频的冲击力和“紧致感”,让底鼓听起来更有力且不浑浊。
- Overboost(过载增强):
- 设置:工作模式:M1;Trim:11.5 dB;FX Lo:100;FX Hi:100;Bands:8;Snap Time:38.2;Body Time:106;Out Gain:-1.7 dB。
- 特点:全频暴力增强。FX Lo 和 FX Hi 都被推到了最大值(100),并配合高 Trim(11.5 dB),会极大地增强所有频率的瞬态。
- 场景:适用于需要极度清晰、充满活力和侵略性的声音。需要极度存在感的乐器。声音会变得非常激进、充满谐波色彩,适合失真吉他或需要破音效果的合成器。
- Mastering Punch(母带处理冲击力):
- 设置:工作模式:M1;Trim:23 dB;FX Lo:21.7;FX Hi:24.3;Bands:24;Snap Time:27.3;Body Time:72.1;Out Gain:-0.5 dB。
- 特点:高精度处理。Bands 高达 24,Snap Time 极短(27.3),Trim 极高(23dB)。旨在为完整混音的母带处理提供一种宽泛、平滑但有效的冲击力增强,而不是针对特定频段的极端处理。
- 场景:适用于鼓组总线、混音总线。旨在不破坏整体平衡的前提下,通过极快的反应速度增加整体的“紧绷感”和动态冲击力。
FX1 模式(频谱压缩/增强):这类预设通过“频谱压缩”的方式,提升 quieter 的频谱部分,让人声或乐器在混音中更“突出”和“融合”。
- Flatter Spectrum(平坦频谱):
- 设置:工作模式:FX1;Trim:22 dB;FX Lo:61.2;FX Hi:51.1;Bands:23;Snap Time:31.1;Body Time:127;Out Gain:0.6 dB。
- 特点:中高频侧重。Trim 高(22dB),FX Lo(61.2)> FX Hi(51.1),Body Time 较长。它旨在“压平”频谱,减少音色上的巨大差异,使声音更统一。
- 场景:适用于人声主唱、独奏乐器。它会填补声音频谱中的“空洞”,让声音听起来更厚实、更平滑,减少齿音的尖锐感,增加温暖感。
- Tighter Mix(更紧凑的混音):
- 设置:工作模式:FX1;Trim:28 dB;FX Lo:26.1;FX Hi:19.5;Bands:30;Snap Time:38.2;Body Time:106;Out Gain:0.3 dB。
- 特点:侧重中低频控制。Bands 极多(30),Snap Time 适中,Trim 极高(28dB)。这种组合会产生一种非常平滑、高度融合且“紧致”的效果。
- 场景:适合用于混音总线、鼓组。利用高波段数(30 Bands)对整体频谱进行精细的“收紧”处理,减少浑浊感,让混音听起来更凝聚、更专业。
M3/M3+模式(瞬态抑制/平滑):这类预设用于“驯服”声音,去除刺耳感和不必要的共振,起到抛光和柔化的作用。
- Smoother Vocals(更平滑的人声):
- 设置:工作模式:M3;Trim:30.1 dB;FX Lo:100;FX Hi:100;Bands:20;Snap Time:30.9;Body Time:61.2;Out Gain:0 dB。
- 特点:极致平滑。FX Lo/HI 均为 100,Trim 高(30.1dB)。意味着它会全力抑制人声中所有频率的瞬态和共振。Trim 也较高(30.1 dB)。
- 场景:专门用于处理粗糙、齿音重的人声、尖锐的弦乐或有爆破音的人声录音。这是一个强力的“去齿音”和“柔化”预设,能有效去除高频的刺耳感,让声音变得丝滑。
- Mix Polisher(混音抛光器):
- 设置:工作模式:M3+;Trim:22.8 dB;FX Lo:25;FX Hi:24.9;Bands:15;Snap Time:24.4;Body Time:74;Out Gain:0.7 dB。
- 特点:温和抛光。参数较为保守(FX Lo/HI ~25),Snap Time 较短(24.4)。意味着这是一个更微妙、更温和的处理。
- 场景:适用于最终母带处理、混音总线。这是一个“润色”预设。它会轻微抑制过强的瞬态,让整体听感更圆润、更专业,类似于在声音表面涂上一层清漆。
人声旁白
针对的电子合成男声旁白(振幅-6 dB),“冷硬、瞬态忽强忽弱、特定辅音刺耳”的问题,使用 Voxengo Peakbuster 是一个非常合适的选择。它不仅能处理瞬态(Transients),还能通过其独特的多频段处理和“谐波着色”来改变声音的质感,这正是解决“电子合成感”和“冷硬感”所需要的。针对需求——“平滑自然”(解决刺耳和过硬)和“干净清晰”(解决穿透力不足),采用文档中提到的“双插件串联”高级技巧:
第一个 Peakbuster:M3+模式(打磨与重塑)
- 目标:“驯服”那些过猛的瞬态,针对性地消除电子合成声可能存在的数码味、齿音或中频的“塑料感”,同时控制整体电平。
- Mode:M3+。理由:抑制瞬态和共振,起到“抛光”和“柔化”的作用。
- Trim:25 ~ 30 dB。理由:提高算法的“偏置增益”,让处理效果更明显,更容易找到“甜点”。
- FX Lo:40 ~ 60%。理由:适度保留并轻微增强极低频的能量,为男声旁白提供扎实的地基,但不至于浑浊。
- FX Hi:80 ~ 90%。理由:全频段抑制,特别是针对你提到的高频刺耳感。
- Bands:20 ~ 30。理由:更多的频段意味着更精细的处理,能更精准地只切掉刺耳的部分,而不影响整体音色。
- Snap Time:25 ~ 30 ms。理由:适中的数值,既不要太快导致残留攻击性,也不要太慢导致声音发虚。
- Body Time:60 ~ 80 ms。理由:稍微增加声音主体的时长,让声音听起来更厚实,减少“干瘪”的电子感。
- Out Gain:+1 dB。理由:补偿因处理而损失的音量,保持电平一致。
第二个 Peakbuster:M1 模式(增加清晰度)
- 目标:在柔化之后,把声音的“骨架”拉回来,增加穿透力和清晰度。
- Mode:M1。解析:瞬态增强模式。它不会像传统压缩器那样压扁声音,而是像 EQ 一样把关键的起音点(Attack)提亮。
- Trim:10 dB。解析:增加动态的活跃度,对抗合成声音的“软绵绵”感。
- FX Lo:50 ~ 60%。解析:适度提升中低频的清晰度,让人声听起来更结实。
- FX Hi:40 ~ 50%。解析:适当提升高频,可以增加“空气感”和“清晰度”,让那些原本“偏软”的字变得有穿透力,但因为前面有 M3 压着,这里不会变得刺耳。
- Bands:15。解析:专注于人声中高频的核心区域,确保恢复出来的瞬态足够自然。
- Snap Time:40 ~ 50 ms。解析:相比第一步的快速压制,这一步的增强可以稍微慢一点,让声音的起振更圆润,听起来更像真人的发声习惯。
- Body Time:80 ~ 100 ms。解析:较长的 Body Time 可以增加声音的延音和饱满度,有效解决“有的字瞬态偏软、听起来没劲”的问题,让声音更“润”。
- Out Gain:+0.5 dB。解析:M1 模式在提升瞬态时通常会带来轻微的音量衰减,这里做微小的补偿,确保经过两级处理后,最终输出电平依然保持在健康的-6dB 左右,方便后续接入限幅器或总线处理。
单插件“抛光”
如果你只想用一个 Peakbuster,那么直接使用 M3+模式,并参考文档中的"Smoother Vocals"(更平滑的人声)预设进行微调。
- Mode(模式):M3+(首选)或 M3。
- Trim:25 dB(直接使用文档推荐的"Mix Polisher"数值,或者根据刺耳程度调整到 25-30)。
- FX Lo:50。
- FX Hi:80。注意:这里的 FX Lo/HI 数值较低,意味着处理量比较温和,适合整体抛光。如果你觉得“财”字还是很刺耳,可以尝试将 FX Hi 提高到 60-80,专门针对高频刺耳感。
- Bands:20。
- Snap Time:32(较短,保持人声的自然度)。
- Body Time:80。
- Out Gain:0.7 dB(根据实际输出音量微调)。
Elephant
Voxengo Elephant:专业母带限制器。最核心的设计目标是实现信号限制的声学透明度,能够在不产生任何可闻“毛刺”或“抽吸”伪影的前提下,完成声音限制与响度最大化。该插件全面支持立体声及多声道处理,兼容所有标准采样率。内置的线性相位过采样技术可实现高质量的峰值限制,有效避免样间过冲(True-Peak 限制),是专业母带处理流程中不可或缺的工具。
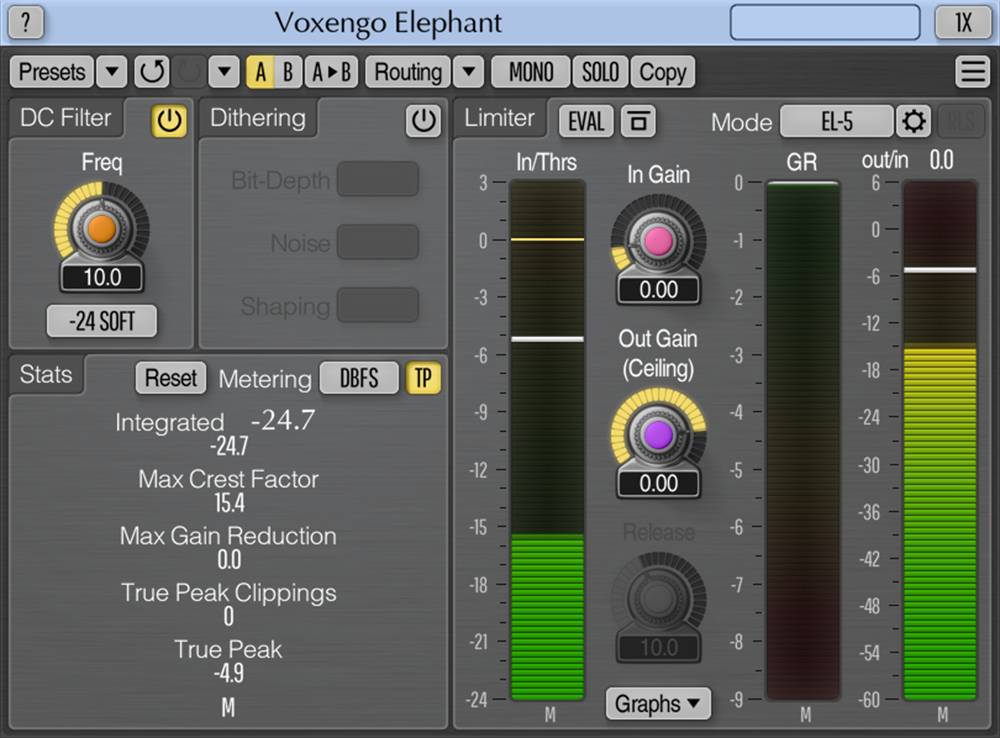
DC Filter:直流滤波器。用于移除信号中的直流偏移及不必要的超低频成分。
- Freq:指定高通滤波器的截止频率。通常建议设置在 5Hz 以下以仅移除直流偏移;若无超低音扬声器,建议调至约 35Hz。
- 滤波器类型选择器:
- Steep:陡峭。提供更高的滚降斜率,但相位偏移更大。
- Soft:柔和。提供更平滑的截止响应和更低的整体相位偏移。
- 命名规则:数字代表 dB/octave 滚降斜率(例如-18 Soft 表示-18 dB/octave 柔和滤波器)。
- 注意事项:DC 滤波器会引入相位偏移,可能改变声音特性。建议将频率尽可能设低,并优先使用非陡峭(Soft)滤波器类型。
- 常规使用:-24 Soft,截止频率 10Hz。
- 无超低音系统:40Hz 截止以移除多余低频。
- 技术用途:低于 20Hz 以移除不必要的低频振荡和 DC 偏移。
Dithering:抖动。启用后,抖动处理位于整个处理链的最后阶段(输出增益之后)。
- Bit-Depth:指定抖动深度。16-bit 适用于 CD 制作,24-bit 适用于预母带和存档。
- Noise:概率密度函数 PDF。
- TPDF:三角 PDF(2-bit 峰峰值),行业标准。
- Gauss:高斯 PDF 近似(Elephant v2 原版使用)。
- 1-Bit:1-bit 峰峰值均匀 PDF,噪声底最低(TPDF 比其高 1.8dB,Gauss 高 2.6dB)。
- Shaping:噪声整形。
- Off:无噪声整形。
- Equal:等响度轮廓整形,跟随人耳听觉阈值。
- Classic:Elephant v2 引入的经典噪声整形。
- 重要提示:启用抖动时,Elephant 必须放在 FX 链最后,且主总线增益设为 0dB。导出时务必关闭宿主软件自带的抖动功能。
Limiter:限制器主控制面板:
- Mode 选择器:加载工厂或用户预设模式。点击 Gears 按钮可打开限制器模式编辑器。
- In Gain 旋钮:控制进入限制器阶段的信号音量(内部音频限制到 0 dBFS)。
- Out Gain/Ceiling 旋钮:调整限制后的输出音量(相当于天花板控制),精度高于 In Gain。
- Release 控制:影响释放阶段持续时间,需先启用 Rls 开关。
- Eval 开关:评估模式。使用 80 dB SPL 等响度轮廓滤波匹配输入/输出电平,便于精准听出失真。
- Graph 按钮:打开实时增益缩减和波形图视图。
Limiter Mode Editor:限制器模式编辑器。算法选择器(Alg)
- Clip:纯硬饱和限制器,声音干净,保留频率平衡和瞬态起音。建议配合过采样使用。
- AIGC:内置自动输入增益控制。AIGC-3/4 为 1/2 的更干净变体。高 In Gain 下可能产生抽吸声。
- EL-1:经典算法,可实现高响度但失真相对较高,不推荐常规使用。
- EL UNI:统一限制算法,包含失真最小化技术和多种动态响应,提供最高灵活性。
- EL-4:基于 EL UNI 的成熟拓扑,通过新控制元素减少失真。听感更“安静”,可通过减小 Lookahead 增加咬合力。
- EL-C:最新版本,基于压缩器的前馈/反馈方式,固定内部时间常数。听感更“平滑”,瞬态失真更少。
- EL INS:即时限制器算法,无释放时间元素但有前瞻瞬态平滑。适合 EDM,效率高但失真较多。
- EL-5:结合 EL-4 和 AIGC 优点,比 EL-4 柔和,比 AIGC 精确。保留动态结构并带有独特的“新鲜感”。
动态与瞬态控制:
- DRC(动态释放控制):动态调整释放包络以模拟原始声音,减少响度摆动和抽吸伪影。DRC Exp 模式可进一步减少响度摆动并提供更高冲击力,但会增加瞬态失真。
- EL Dyn(弹性动态响应):适用于 EL-1、EL UNI、EL-4 算法的附加动态响应类型,不同模式恢复速度略有差异,在重度压缩时最明显。
- Ch. Link(通道链接):控制组内通道之间的链接程度。完全 unlink 可获得更高增益但可能破坏立体声场;完全 link 则保持立体声场信息。
- Knee(拐点):控制传递函数的软拐点。较宽的拐点声音更平滑,较低的值适合更硬的声音。
- Timing(时间常数):以百分比调整内部时间常数(40 为最小,500 为最大)。较高值声音更紧凑但增加瞬态失真,透明处理建议使用 250 以下的值。
- Rls/Atk Ratio(释放/起音比):调整内部释放与起音时间常数的比值。低比值(接近 1:1)声音更响更亮;高比值声音更安静,低频更好,高频略暗。
- Rls Shape(释放形状):接近-1 产生更丰满、快速释放的声音;接近 1 及更高值产生更薄、更扩展的声音;接近 2 提供更高透明度。
- Trans 控制组(瞬态控制):
- Trans 开关:Classic(原版)、Sharp(更尖锐即时,增加谐波色彩)、Asymm(非对称模拟瞬态,色彩居中)。
- Lookahead 旋钮:较低值更刺耳但响度提升和冲击力更高;较高值更平滑,保留瞬态形状。
- Tr. Shape 参数:低于 0 产生更平滑形式,高于 0 产生更尖锐形式。
- Trans View:可视化显示限制器瞬态的近似外观。
Stats(统计面板)
- Integrated:集成信号功率估计。
- Max Crest Factor:最大峰值因子(集成 RMS 与峰值 RMS 之间的差异)。
- Max Gain Reduction:最大即时增益缩减值。
- True Peak/Peak:1-sample 输出真峰值/采样峰值电平。通过 TP 开关切换。
- Reset 按钮:重置计数器和统计积累。
Metering(计量模式)
- dBFS / dBFS.30 / dBFS.15:无偏置模式,提供不同的计量范围。
- dBFS+3:增加 3dB 偏置。
- K-20 / K-14 / K-12:Bob Katz 的 K 系统计量模式。
- K-20 C / K-14 C / K-12 C:K 系统电平校准模式,固定 600ms 积分和释放时间。
- LUFS / LU:EBU-R128 K 加权计量标准。
- ML / SL 后缀:ML 显示瞬时响度(0.4秒积分窗口),SL 显示短期响度(3秒积分窗口)。
Level Meters(电平表)
- In/Thrs:输入电平表,带与 In Gain 关联的限制阈值标记。
- GR:绝对增益缩减表。
- Out:输出电平表。