Zynaptiq 插件1
Zynaptiq是一家总部位于德国汉诺威的音频软件公司,成立于 2011 年,由 Denis Goekdag 和 Stephan M. Bernsee 共同创立。其技术底蕴非常深厚,在业内以“黑科技”和前瞻性的创新思维著称。他们专注于利用人工智能(AI)、机器学习和先进的数字信号处理(DSP)技术,开发出一系列突破性的音频插件。对于日常处理电子合成人声旁白、进行复杂后期制作的工作流来说,Zynaptiq 提供的工具往往能解决传统插件难以应对的痛点,堪称提升效率和音质的“智能助手”。他们不热衷于复刻传统的模拟硬件,而是致力于用前沿算法解决音频处理中的极限问题。
- UnChirp:编码伪影修复。专门消除有损音频压缩(如低码率 MP3)或频谱降噪产生的“水下声”、“鸟叫声”等高频伪影,并恢复丢失的高频细节。
UnChirp
Zynaptiq UnChirp:专业音频修复与增强插件,专门用于修复数字音频处理流程中产生的各类伪影(Artifacts)。这些伪影常见于有损音频编解码器(MP3、AAC 等)、频域降噪器、以及基于 FFT 的各类 DSP 处理环节,但也可能源于其他信号处理过程。UnChirp 能够精准识别并消除这些伪影,对存在缺陷的音频进行修复,也可直接为优质录音增添轮廓感与鲜活质感。
核心功能:
- 修复音乐噪声(Musical Noise):低频到中频的随机杂音。即随机出现的伪单音失真,是降噪类处理最常见的副作用。
- 消除“啁啾声”(Chirping):高频调制伪影,俗称"鸟叫声"、"水下声"或"The Tweeties",是高频区域类似流水感的异常(Artifacts)。
- 改善瞬态模糊(Transient Smearing):解决 FFT 线性相位特性带来的瞬态拖尾、回声类失真。
- 整体“发糊”(Blurring):由于时域定位精度低,导致的整体清晰度下降。
- 高频损失:补充 FFT 类处理、有损编码造成的高频丢失问题,还原缺失的高频细节。编码器和降噪器通常会丢弃高频内容。
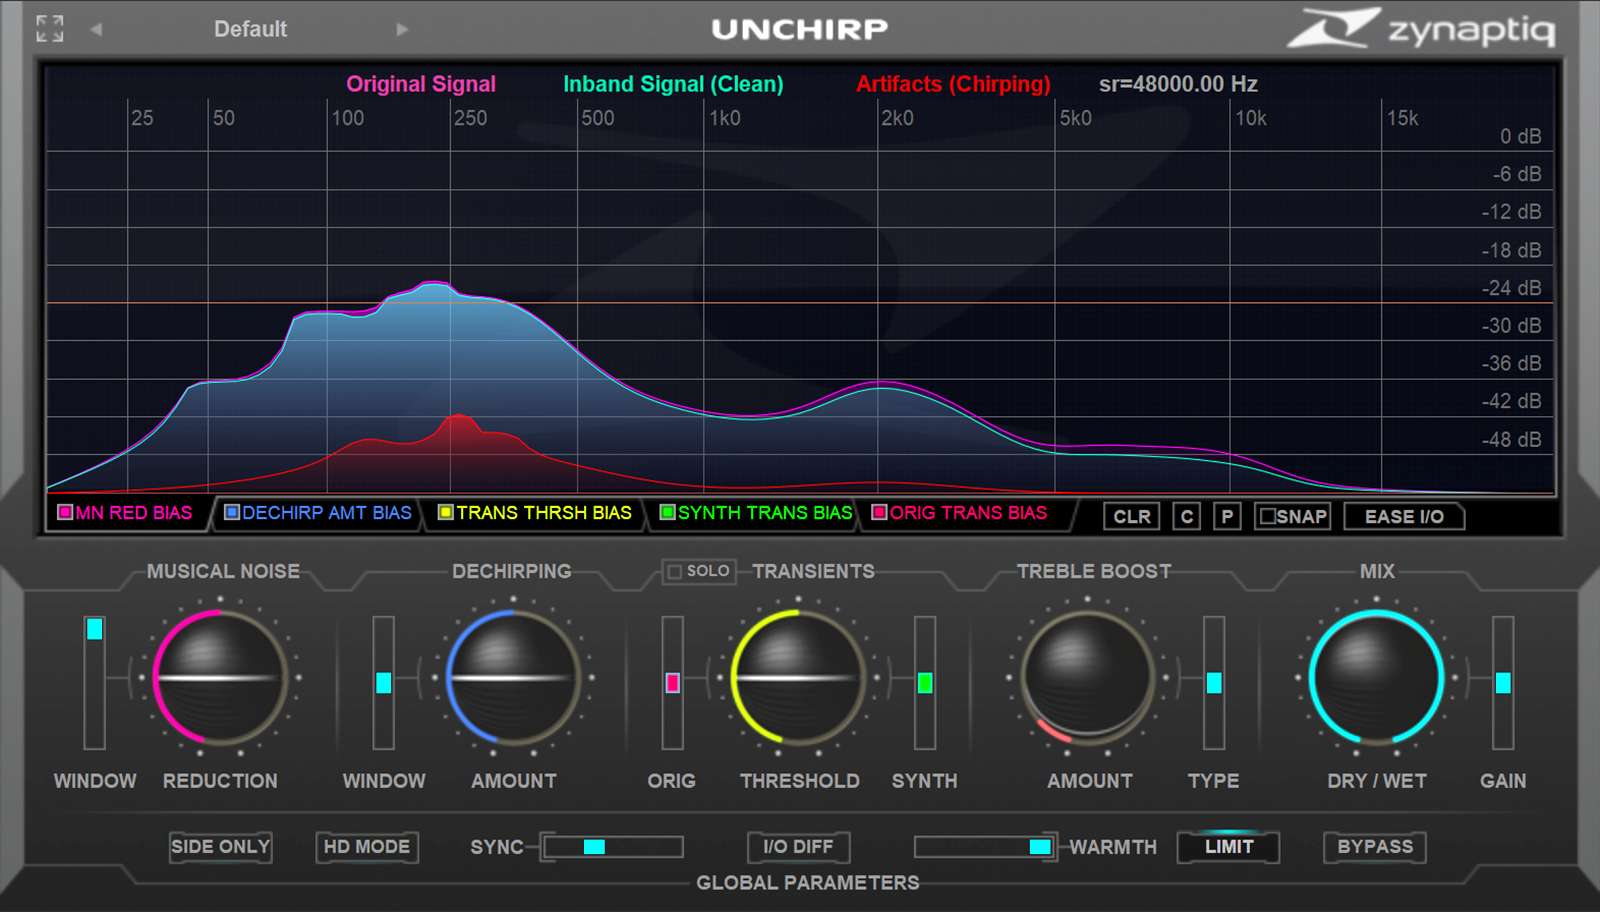
图形显示:
- 输入信号:洋红色(Magenta)。
- 这是未经处理的原始输入信号的幅值-频率对应图,是进入 UnChirp 处理前原始输入信号的实时可视化。
- 这个分析显示精度极高,在低频声音段甚至可以直接观察到音频的独立谐波,并非仅能展示粗略的频谱包络。
- 当信号中存在大量伪影时,洋红色曲线上会呈现出符合伪影特征的不规则波动,在 2k Hz 以上的中高频段这类异常形态会更加突出。
- 如果素材经过低比特率有损编码,洋红色曲线通常会在 10k Hz 以上的高频区域出现明显的幅值陡降,直观反映出编码器丢弃了该频段的高频信息。
- 洋红色曲线始终可见,作为你调整其他参数时的视觉参照。
- 干净信号:薄荷绿(Mint)。
- 薄荷绿色曲线代表插件提取出的有效干净信号分量,也就是算法判定属于音频本身的非伪影内容。
- 薄荷绿色的曲线形态通常会比洋红色原始信号曲线更平滑自然,已经剔除了伪影带来的各类不规则波动。
- 在伪影严重的频段,薄荷绿曲线和洋红色曲线之间会出现清晰的幅值差,两条曲线的分离程度越高,说明该频段的伪影能量占比越高。
- 如果两条曲线几乎完全重合,代表该频段没有检测到明显的伪影,或是当前设置的处理参数偏保守,几乎没有执行信号分离操作。
- 伪影信号:红色(Red)。
- 算法判定为 Musical Noise、Chirp、瞬态模糊等伪影部分。
- 洋红色 ≈ 薄荷色 + 红色(在算法的分离模型中)。
- 红色曲线越高的频段,说明该频段的伪影能量越大,越需要处理。
- 如果整个频段红色曲线都很低(贴近底部),说明素材质量较好,伪影很少。
| 视觉特征 | 说明 | 对应的问题 |
| 洋红色曲线在高频段(>8kHz)急剧下降 | 高频信息被编码器/降噪器丢弃 | 需要 Treble Boost |
| 洋红色曲线出现密集的细小锯齿/毛刺 | Musical Noise(音乐噪声) | 需要 Musical Noise Reduction |
| 洋红色曲线在 3-10kHz 区间有不规则的隆起包 | 高频 Chirp 伪影 | 需要 Dechirping |
| 洋红色与薄荷色曲线在中频段大面积分离 | 中频存在较多伪影成分 | 加大 Reduction 或 Dechirping Amount |
| 红色曲线整体很低,三条线几乎重叠 | 素材质量好,伪影极少 | 可能不需要太多处理,或用于增强 |
断点编辑器
显示区不仅仅是"看"的——它还是一个可交互的断点曲线编辑器,用于创建频率相关的处理偏置曲线。断点编辑器支持创建 5 条独立的自由形态曲线,每条曲线对应一项核心处理参数的频率偏置调整,不同曲线用专属颜色标识,你可以点击编辑器下方的对应标签切换当前要编辑的曲线,每个标签左侧都有独立的开关,可以随时开启/关闭对应偏置曲线方便前后效果对比:
- 洋红色:MN Red Bias,对应音乐噪声消减强度参数的频段偏置。
- 蓝色:DeChirp AMT Bias,对应去啁啾处理强度参数的频段偏置。
- 黄色:Trans Thrsh Bias,对应瞬态触发阈值参数的频段偏置。
- 绿色:Synth Trans Bias,对应合成瞬态电平参数的频段偏置。
- 红色:Orig Trans Bias,对应原始瞬态电平参数的频段偏置。
拖拽节点时,界面会实时显示当前节点的坐标数值:横轴为频率(Hz),纵轴为偏置取值,范围在 -1 到 +1 之间。偏置数值会叠加到对应参数的当前设置上,超出 -1 到 +1 范围的总和会被自动截断,相当于既可以给参数基础值做正向增强,也可以针对特定频段做反向弱化处理。
节点增删
- 新增节点:直接在编辑器的任意区域点击,即可在对应位置插入新的编辑节点。
- 删除单个节点:有三种方式可选,第一种是右键 / CTRL 点击目标节点;第二种是将节点拖拽出编辑器区域后松开鼠标;第三种是选中节点后按下 Delete / Backspace 键。
- 批量删除节点:选中多个节点后,执行上述任意一种删除操作,即可一次性移除所有选中的节点。
- 边缘节点特殊规则:最左侧和最右侧的首尾节点无法被删除,对这两个节点右键/CTRL点击,会直接将其重置到垂直居中的 0 偏置位置。
- 快速清空操作:点击 CLR 按钮,会清空当前选中曲线的所有中间节点,仅保留首尾节点并将其重置为 0 偏置;如果按下 Alt/Option 同时点击 CLR 按钮,会一次性清空5条曲线的所有自定义节点。
- 曲线快速复用:点击C按钮可以复制当前选中的曲线设置,点击 P 按钮即可将之前复制的曲线粘贴到当前正在编辑的曲线中,实现不同参数曲线的快速复用。
节点选择与移动
- 选中单个节点:直接点击对应节点即可完成选中。
- 批量选择节点:按住 Shift 点击未选中的节点,可以将其加入选中集合;在编辑器区域内按住 Shift 拖拽鼠标,拉出选框即可一次性选中框内所有节点。
- 取消选中:按住 Shift 点击已选中的节点,可将其从选中集合中移除;在编辑器的空白区域点击,会直接清空所有节点的选中状态。
- 移动节点:拖拽选中的单个/多个节点即可调整位置,也可以在选中节点后用键盘方向键、鼠标滚轮来微调位置。
- 移动限制规则:首尾两个节点仅支持垂直方向移动;拖动节点水平穿过其他节点时,松开鼠标后会自动删掉被穿过的节点,拖动时不松开鼠标反向拉回,被删除的节点可以恢复;如果选中多个节点拖动,当其中任意一个节点碰到编辑器的水平/垂直边界时,整组节点的对应方向移动就会停止,避免误操作把节点拖出编辑器导致丢失。
SNAP 吸附功能:开启 SNAP 开关后,当节点被移动到距离 0 偏置基准线 ±14 像素的范围内时,节点会自动吸附到 0 值位置,可以快速将指定频率范围的偏置值归零。
自定义曲线形态:通过曲线类型选择器,可以修改所有节点之间线段的连接形态,5 种连接形态会作用于全部 5 条偏置曲线:
- Linear(线性):用直线直接连接相邻的两个节点。
- EASE I/O(缓入缓出):在两个节点之间生成平滑过渡的曲线。
- PEAK/DIP(峰/谷):生成以 0 值为中心的窄峰或窄谷曲线,曲线的 Q 值由相邻节点之间的距离决定。
- STEP EDGE(阶跃边缘):生成无过渡的阶梯形态,阶梯的边缘位置和当前节点位置完全对齐。
- STEP MID(阶跃居中):同样生成阶梯形态,不过节点位于阶梯段的中心位置,阶梯的左右边缘位于当前节点和相邻两个节点的频率中点位置。
| UnChirp 模块 | 伪影信号特征 | 产生原因 | 常见来源 |
| Musical Noise | 中低频随机音调(random tones) | 由噪声信号分量反复穿越检测阈值被开关切换产生 | 频域降噪过度、有损编码、声码器周期性条纹 |
| Dechirping | 高频 FFT 阈值处理伪影,人耳感知为背景"水流声" | 因 FFT 恒定带宽滤波器与人耳变带宽感知不匹配产生 | STFT 帧间相位不连续、声码器相位推断误差、Phase Vocoder 变速 |
| Transients | 瞬态模糊和预回声,信号听起来有混响感/弥散感 | 瞬态在实际发生前就被淡入 | STFT 加窗涂抹、有损编码的时频权衡、帧拼接不连续 |
| Treble Boost | 高频能量衰减、空气感缺失 | 某频率以上完全无声,常规 EQ 无法恢复;以及 FFT 阈值处理中砖墙低通滤波器在截止频率处引入的振铃 | 有损编码器的带宽缩减(丢弃高频内容)、降噪器的恒定幅度阈值(去除白噪声时连带去除高频)、FFT 阈值处理中的砖墙低通滤波器 |
Musical Noise
Musical Noise:音乐噪声处理模块。中低频随机音调(random tones)。
- 音乐噪声成因:基于 FFT 的处理(如降噪器)使用软/硬阈值去除低幅度分音时,噪声信号分量反复跨越检测阈值而被“开关”,这种快速、随机的“开关”效果,在听感上表现为大量随机出现的短促音调——即音乐噪声。
- Reduction:调节音乐噪声(杂音/游离音)的减少量。从关到最大。经验法则:设到刚好能去除伪影的最小值。
- Window:设置检测音乐噪声伪影的"窗口"长度,即可调节能去除的伪影的最大时长。高值可去除更长的伪影,但设得越低越好,避免去除有用信号和造成"模糊"。
DeChirping
DeChirping:去啁啾处理模块。专门针对高频流水感的啁啾失真设计。
- 高频 Chirp 成因:FFT 对所有频段使用相同带宽的滤波器,而人耳对高频使用更宽的"频带",分辨率较低,无法将高频 FFT 阈值伪影识别为独立音调,而是感知为类似"流水声"的背景效果。
- Amount:设置高频 Chirping 的减少量。可通过 DECHIRP AMT BIAS 断点曲线进行频率相关调节。
- Window:调节要去除的伪影的最大时长。低值用于去除短 Chirp,高值用于去除较长的 Chirp 或"颤音"。设得越短越好,避免去除有用信号和引入"模糊"。
Transients
Transients:瞬态处理模块。过瞬态合成(Transient Synthesis)技术,可以增强或替换这些受损的瞬态,让声音重新获得冲击力和清晰度。
- 瞬态模糊成因:有损编解码器(MP3、AAC 等)和基于 FFT 的处理(如频谱降噪)在分析信号时,需要将音频切分成固定长度的"帧"(通常 1024 或 2048 个采样点)。当一个瞬态(如爆破音 p、t、k)恰好落在帧的边界附近时:帧窗口会平滑掉瞬态的尖锐起始,瞬态的能量被"摊"到整帧中,结果是瞬态变得模糊、发散、缺乏冲击力,这就是你的 TTS 语音中辅音听起来"肉"的原因。
- Threshold:瞬态处理模块的触发敏感度阈值,基于输入信号的统计特性工作。
- 只有当检测到的瞬态强度(显著程度)达到/超过当前阈值时,才会在该瞬态位置同时触发两个绑定动作:
- 把该位置的原始瞬态旁通出来,交给 Orig 处理。
- 在该位置生成合成瞬态,交给 Synth 处理。
- 最后输出的瞬态,由原始瞬态成分、合成瞬态成分,叠加而成。
- 未达到阈值的信号位置,不做任何瞬态专项处理,和普通信号一起走主处理链。
- 最大值:阈值最高,没有任何瞬态的强度能达到触发条件 → 既不旁通任何原始瞬态,也不生成任何合成瞬态;
- 降阈值:阈值中间,触发瞬态处理的门槛逐步降低,越来越多强度稍弱的瞬态会被检测到、触发"旁通原始 + 合成补瞬态"的处理,瞬态修复的介入程度越来越深。
- 最小值:阈值最低,哪怕非常微弱的瞬态都会达到触发条件 → 瞬态处理最激进,几乎所有瞬态位置都会旁通原始信号并叠加合成瞬态,修复力度最大。
- 调试方法:从最大值开始,缓慢降低。配合 Solo 按钮监听,直到能清晰听到被检测到的瞬态信号。找到"检测到需要处理的瞬态,但不过度触发"的临界点。
- 使用方法:想要自然的瞬态修复:Orig 居中/略提升,Synth 少量添加;想要重塑更干脆的电子感瞬态:适当降低 Orig、提高 Synth 比例。
阈值越低,被判定为"瞬态"的位置越多。 - 只有当检测到的瞬态强度(显著程度)达到/超过当前阈值时,才会在该瞬态位置同时触发两个绑定动作:
- Orig:调节被旁通的原始瞬态的电平。
- 居中位置(0.5):被旁通的原始瞬态电平不变,即原样保留。
- 最小位置(0.0):被旁通的原始瞬态被静音。即被重塑的瞬态成分中,不再有原始瞬态成分,只剩合成瞬态成分。
- 最大位置(1.0):被旁通的原始瞬态提升 +6dB,增强原始冲击感。
- 断点曲线:由 SYNTH TRANS BIAS 断点曲线按频率叠加偏置。(曲线取值 -1…+1,与当前值相加后裁剪到有效范围)。
- 调试逻辑:素材瞬态质量尚可:往上调,保留更多原始瞬态;瞬态完全糊掉:往下调,减少原始瞬态占比;大多数情况放在中心附近微调。
- Synth:调节合成瞬态的加入量。
- 最小值:关闭合成,不添加任何新瞬态。
- 渐增大:合成的瞬态量逐渐增大,用来填补被去除的模糊/预回声留下的空隙。
- 最大值:合成瞬态量最大,完全用合成瞬态替代。
- 断点曲线:由 SYNTH TRANS BIAS 断点曲线按频率叠加偏置。例如:低频多合成(鼓点),高频少合成(避免齿音过激)。
- 副作用:当 Synth 提升过多时,合成波形和原始波形开始互相干扰:合成瞬态的起振点和原始瞬态不完全重合,可能有 0.5–2 ms 偏差。两个波形叠加后产生相位抵消或增强,听感上就是“回音震荡”或“金属颤音”。
- Solo:只听被处理的部分(原始瞬态 + 合成瞬态)。
TTS(文本转语音)生成的男声通常有以下问题:
- 瞬态模糊:合成语音的辅音(p/t/k/b/d/g)缺乏真实人声的冲击力。
- 高频缺失:齿音(s/sh)和气息感不足。
- 整体发闷:缺乏真实录音的"空气感"和"力度感"。
推荐设置:
- Threshold:中等偏低(约 0.4 - 0.5)。TTS 的瞬态普遍较弱,需要较低阈值。但阈值过低会把 TTS 里的声码器噪声瞬态也一起抓进来,所以要用 Solo 确认抓到的是辅音而不是嘶声。
- Orig:中等偏低(约 0.3 - 0.4)。衰减原始瞬态电平,把“冲击点 + 包裹它的模糊层”整体压低,去掉模糊感。
- Synth:稍微提高(约 0.1 - 0.2)。加入微量合成瞬态填充间隙。过多容易产生相位抵消或增强,听感上就是“回音震荡”或“金属颤音”。
- Solo:调试时开启,完成后关闭。用来确认检测到的瞬态确实是辅音,而不是噪声。
- 注意:TTS 是高度同质的信号,阈值压得过低时,大量并非真瞬态的成分(持续元音的起音、摩擦噪声、声码器抖动的毛刺)也会被拉进瞬态处理,于是合成瞬态密密麻麻地叠上去——听感就是声音是"撞出来的"。
Treble Boost
Treble Boost:高频增强模块。解决编解码器、降噪器导致的高频完全丢失问题。基于心理声学模型的高频恢复电路,提供两种工作模式——Enhance(增强)和 Excite(激励)。
- Enhance 模式:频谱反卷积恢复。它的本质是尝试还原被编解码器删除的高频信息。工作流程:
- 分析:检测信号中哪些高频成分被有损编码"砍掉"了(通过对比中低频的谐波结构,推断缺失的高频应该是什么)。
- 建模:基于心理声学模型,估算被删除的高频成分的频谱包络。
- 合成:生成一个与原始信号谐波结构一致的高频补充信号,叠加回原始信号。
- 关键点:Enhance 模式生成的不是"任意高频",而是与中低频谐波结构数学相关的高频成分——它试图"猜"出被删掉的信息长什么样,然后补回去。
- Excite 模式:谐波激励。本质是通过非线性失真生成新的谐波成分。工作流程:
- 提取:将输入信号通过一个高通滤波器,提取中高频成分作为"源信号"。
- 失真:对源信号施加受控的非线性失真(类似软饱和/波形整形),产生丰富的谐波。
- 混合:将生成的新谐波与原始干信号混合输出。
- 关键点:Excite 模式凭空创造了原始信号中不存在的高频谐波。这些谐波的频率是源信号频率的整数倍(2倍、3倍、4倍……),与音乐/语音的谐波结构自然相关,所以听起来"像真的"。
- Amount:调节添加的高频量。范围很宽,可处理严重退化的素材,需仔细调节。
- Type:增强高频的类型。TYPE 是一个 0.0 到 1.0 之间的连续滑块。
- 0.0(最小值)= Excite:合成新谐波填充"空白"。
- 1.0(最大值)= Enhance:应用心理声学优化的程序相关均衡。
- 0.5 = 默认值:Excite 和 Enhance 各占一半,交叉淡入淡出。
- 如果听到爆裂声,应切换到 Enhance。
TTS(文本转语音)生成的男声在高频段通常有以下问题:
- 高频被"切平":合成引擎为了追求干净,往往会过度平滑高频细节。
- 缺乏气息感:真实男声的呼吸、气声、唇齿摩擦等微细节在 TTS 中几乎不存在。
- 齿音不自然:s/sh 音要么过于尖锐(机械感),要么过于模糊(缺乏清晰度)。
- 整体发闷:缺少真实录音棚男声在 8k-16kHz 的"空气感"。
TS 男声的推荐:
- Amount:0.12。经过测试发现 默认值 0.1,会衰减原来高频的亮度,0.12 基本持平,0.15 会增强高频亮度。
- Type = 0.7 - 0.85:首选区间,偏向 Enhance,保留自然感。
- Type = 0.6:折中方案,适合高频损失较严重的 TTS 素材。
- Type = 0.5(默认):不推荐,Excite 成分过多,容易让 TTS 男声产生"金属感""塑料感"。
- Type < 0.5:强烈不推荐,Excite 主导,极易加剧 TTS 的机械味和齿音刺耳。
全局参数
- Side Only:激活时,输入信号被 Mid-Side 编码,处理仅应用于侧声道。适用于"联合立体声"或 AAC-HE v2 编码的信号,因为阈值伪影通常主要集中在侧声道。
- HD Mode:开启后所有处理以更高的内部分辨率运行,整体效果更好,但 CPU 占用明显增加。
- Sync:将所有处理与信号的瞬态同步,增加整体的清晰度和连贯性。
- 用途:减少瞬态模糊、在激进处理时让声音更紧实、或整体"去模糊"混合信号。
- 警告:非常高的 SYNC 值可能会抑制沙锤等音乐声音,或在持续音期间移除高频内容。
- I/O DIFF:Input/Output Difference。输入与输出的差异,即监听被去除的部分。用于精细调试。注意:其中不包含"添加"的部分,所以不含 Treble Boost 和瞬态合成效果。
- Warmth:去除音乐噪声和 Chirp 后,FFT 的规则性可能变得可闻(轻微"嗡嗡"声或"金属谐振")。Warmth 通过添加随机调制来打破 FFT 处理的规律性,使声音更自然。过高值可能导致瞬态细节损失。
- Limit:激活砖墙限制器(固定阈值 0 dBFS),防止削波。注意这是非常快的限制器,如果提升瞬态但听不到更多瞬态,很可能是限制器在"吃掉"它们。
- ByPass:绕过所有处理,将输入信号直接路由到输出。
Mix:混音模块。
- Dry/Wet:全局干/湿混合控制。
- Gain:输出增益,位于 Dry/Wet 之后、输出限制器之前。