TTS 人声:频率均衡咬字清晰(干净篇)
TTS 人声(Text-to-Speech、AI 文本转语音)具备的缺点:
- 缺乏共鸣:缺乏真实的胸腔、咽喉、口腔等共鸣。在中低频缺乏,或者堆积。听起来,缺乏真人气息。
- 听感冷硬:瞬态响应太快太强,不柔和。由于缺乏内在的真实情感驱动,导致语调生硬。
- 机器感重:具有均匀的节拍、不变的音色以及僵化的重音,缺乏人类说话时微妙的时间抖动和气息变化。
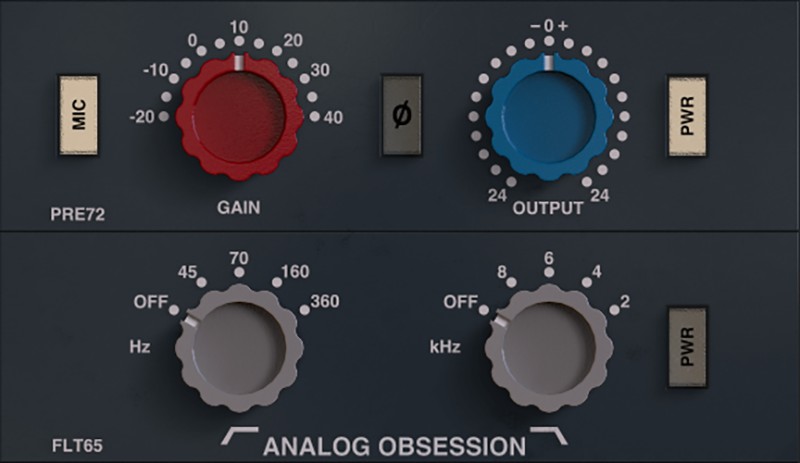
前级话放
Analog Obsession BritPre:增加中高频冲击力,减少中频空洞。
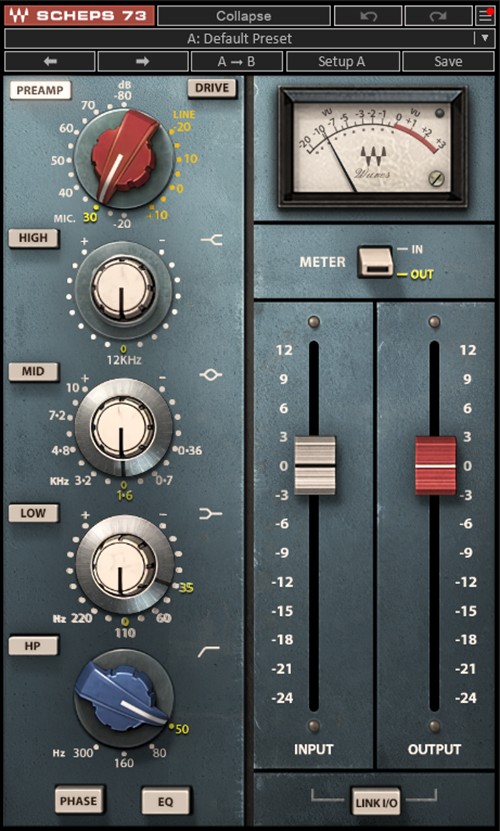
Scheps 73
RRS Scheps 73:中低频温暖厚重、增强胸腔共鸣。
多段压缩
Three-Body Tech Future MB:多频段处理器。
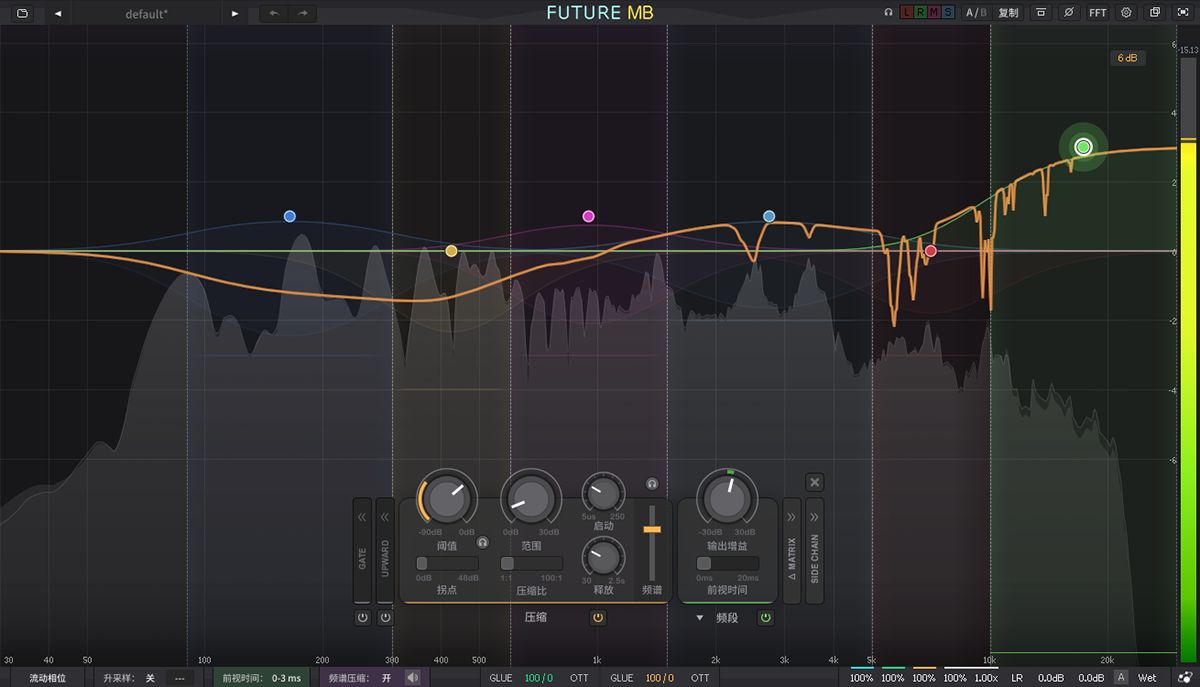
- 相位模式:流动相位;升采样:2x;全局前视:0-5 ms;风格:Glue。
- 频率波段:80 Hz ~ 250 Hz。
- 压缩阈值:-22 dB;范围:6 dB;启动:20 ms;释放:150ms;拐点:9 dB;压缩比:2:1。频谱压缩:40%。
- 输出增益:0 dB。前瞻时间:3ms。
- 增益矩阵:接收 Band 1:30%,提升。中频衰减时,少量路由到低频增加温暖感。
- 频率波段:250 Hz ~ 600 Hz。
- 压缩阈值:-24 dB;范围:8 dB;启动:15 ms;释放:120 ms;拐点:6 dB;压缩比:3:1。频谱压缩:40%。
- 输出增益:0 dB。前瞻时间:5ms。
- 增益矩阵:自身 :75%;Band 0:-30%; Band 2:-25%。
- 频率波段:600 Hz ~ 2k Hz。
- 向上压缩:阈值1:-30 dB;阈值2:-48 dB;范围:10 dB;启动:15 ms;释放:100 ms;压缩比:2.5:1;拐点:6 dB。向上频谱:25%。
- 压缩阈值:-21;范围:4 dB;启动:15 ms;释放:100 ms;拐点:9 dB;压缩比:2:1。频谱压缩:20%。
- 输出增益:0 dB。前瞻时间:3ms。
- 频率波段:2k Hz ~ 5.5k Hz。
- 压缩阈值:-22;范围:4 dB;启动:10 ms;释放:100 ms;拐点:4 dB;压缩比:2:1。频谱压缩:30%。
- 输出增益:0 dB。前瞻时间:5ms。
- 频率波段:5.5k Hz ~ 20k Hz。
- 压缩阈值:-24;范围:3 dB;启动:10 ms;释放:100 ms;拐点:3 dB;压缩比:2:1。频谱压缩:20%。
- 输出增益:0 dB。前瞻时间:3ms。
动态均衡
waves CLA-2A:压缩量 1 ~ 3 dB,最大不超过 5 dB。
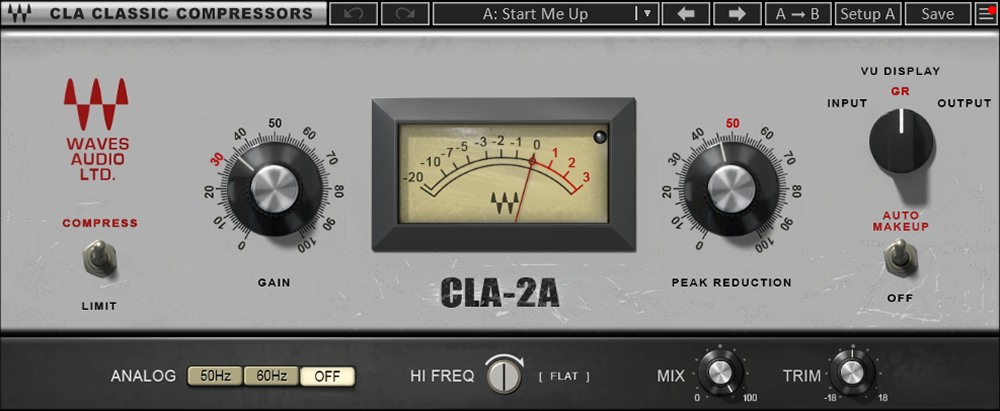
Peak Reduction:47 dB,Gain:34 dB。