FabFilter(肥波)插件1
FabFilter是荷兰一家广受赞誉的音频处理软件厂商,其生产的产品因其简单直观的用户界面、高质量音频处理和灵活的控制而备受推崇。
- FabFilter
Pro-Q 4:均衡器,具有完美的模拟建模、动态均衡器、线性相位处理和出色的界面,具有无与伦比的易用性。这款强大的均衡器插件能精细调整音频频率响应。
Pro-Q 4
Fabfilter Pro-Q 4:音频行业标准的均衡器插件。集成了动态处理、频谱修复、模拟饱和及多实例管理。
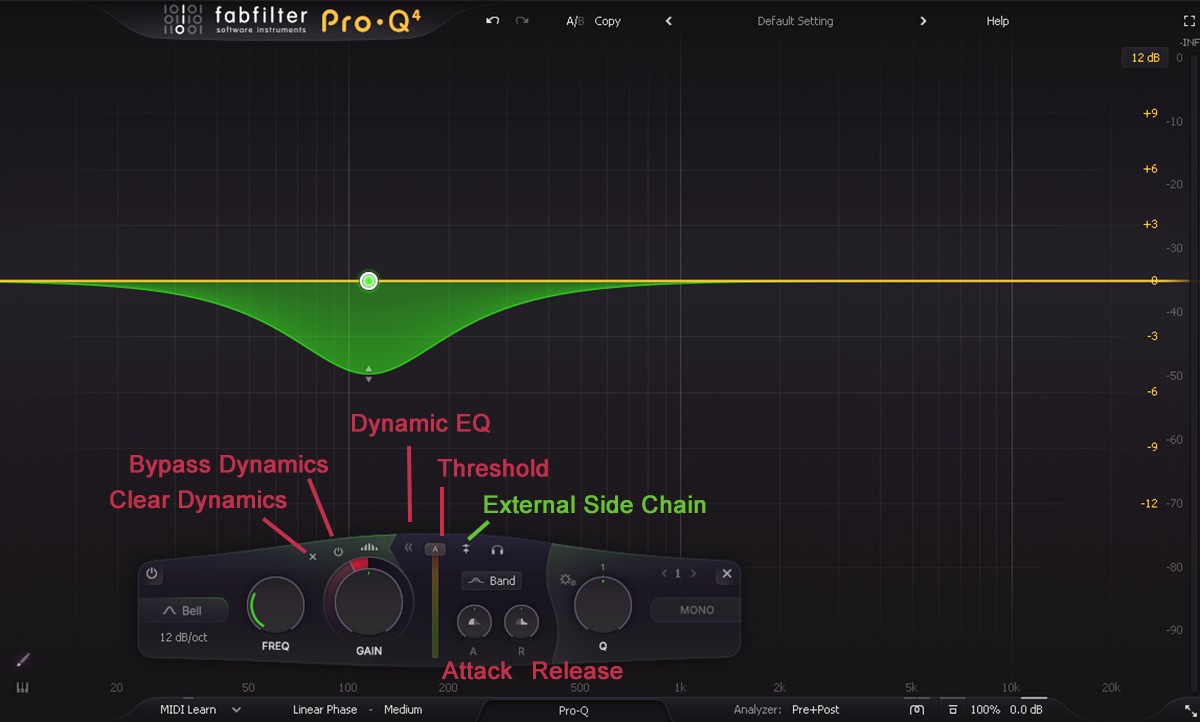
当频段被设为动态后,会显示额外的控制面板。点击动态范围环上的展开按钮(expand)可查看详细参数:
- External Side Chain:外部侧链。切换触发信号源。
- 默认:使用插件输入的信号(Input)。
- 开启后:使用外部侧链输入的信号作为触发源。这允许你用一条轨道的信号(如底鼓)去控制另一条轨道(如贝斯)的 EQ 变化。
- 注意:即使使用外部侧链,触发信号依然会受到上述"Band"或"Free"滤波设置的限制。
- Audition:试听按钮。按住此按钮可以单独听到用于触发的侧链信号,帮助你不凭猜测地设置触发频率。
- Clear Dynamics:将动态范围重置为 0 dB,完全移除动态属性,变回普通静态频段。
- Bypass Dynamics:暂时关闭动态行为,频段变回静态 EQ,但保留动态参数设置。
动态 EQ
- Triggering:触发源设置。
- Band:频段触发。默认。动态处理仅由该频段频率范围内的信号触发。这是最常用的模式,具有“手术刀”般的精准度。
- Free:自由触发。选择此项后,会出现额外的低切(Low-cut)和高切(High-cut)滤波器控件。你可以自定义触发信号的频率范围,使其不同于实际处理的频段。
- Threshold:阈值。设定触发动态处理的电平阈值。
- 自动模式(Auto):默认情况下,滑块位于顶部(显示"A"),阈值会根据带限触发信号的电平自动调整。
- 手动模式:点击展开面板后,可手动拖动滑块设定固定阈值。滑块上会显示触发信号的电平,辅助你找到合适的触发点。
- 软拐点(Soft Knee):算法内部使用软拐点,意味着处理会在略低于设定阈值时就开始平滑介入。
- Dynamic Range:动态范围。设定动态处理的强度,范围为-30 dB 到+30 dB。
- 负值:表示压缩(Compression)。当信号超过阈值时,增益会降低。
- 正值:表示扩展(Expansion)。当信号超过阈值时,增益会增加。
- 视觉:环内黄色的条形指示器显示当前的实时增益变化量,红色部分指示设定的动态范围上限。
- Attack & Release:启动与释放。控制动态变化的速度。
- 自动模式:中心位置(50%),代表自动模式,此时 Attack 和 Release 由插件根据音频内容自动优化。
- 手动调整:向左(低数值)调快,向右(高数值)调慢。这允许你对瞬态(如鼓的打击感)或长尾音进行更精确的控制。
Attack、Release、Knee,并不是固定的数值,而是取决于以下三个因素:
- 被处理的音频素材:插件会分析当前的音频内容。
- 均衡器频段所在的频率范围:不同频率会有不同的响应特性。
- 当前的动态范围设置:设定的压缩或扩展强度也会影响响应时间。
结果:这种设计能产生非常自然、平滑的压缩和扩展效果,适用于广泛的动态均衡应用场景,无需用户手动去“死磕”毫秒数。
- 默认设置:50%(全自动模式)
- 自动模式:当你把旋钮保持在正中间的 50%位置时,激活 Pro-Q 4 的智能程序依赖模式。
- 如何工作:此时,插件会根据你当前处理的频率(低频通常慢,高频通常快)、音频素材(瞬态强的声音反应快)以及动态范围(压缩得越狠,反应越平滑)自动计算最佳时间。
- 适用场景:90%的情况。对于大多数人声旁白、音乐混音,这个默认设置能提供最自然、最不易察觉的处理效果,完全不需要你手动干预。
- 手动微调:当你觉得智能模式不够完美,需要更极端的控制时,你需要打破 50%的平衡。
- 向左旋转(0%- 49%):追求“更快、更硬”
- 逻辑:你告诉算法:“我要比自动模式更快的反应速度。”
- 听感变化:旋钮越接近 0%,Attack/Release 时间越短。压缩器会像一堵墙一样瞬间抓住声音。
- Attack 调快:当你需要消除极快的瞬态噪音(如极尖锐的齿音、爆破音),且自动模式反应不过来时。
- Release 调快:当你需要极高频的“抽吸”效果(特殊音效),或者处理极短促的打击乐时。如果你觉得声音的尾音还在“乱窜”或者压缩感不够紧实,尝试将 Release 向左(快)微调,比如到 40%。
- 向右旋转(51%- 100%):追求“更慢、更柔”
- 逻辑:你告诉算法:“我要比自动模式更慢的恢复速度。”
- 听感变化:旋钮越接近 100%,时间越长。压缩器会变得“迟钝”,慢慢抓住声音,慢慢松开。
- Attack 调慢:当你想保留低频的冲击力(Punch),不想让压缩器把低音的“头”削掉时。如果你觉得声音被压得有点“闷”或失去了弹性,尝试将 Attack 向右(慢)微调,比如到 60%。
- Release 调慢:当你想让人声或贝斯的尾音更平滑、更连贯,避免音量忽大忽小(呼吸感)时。
- 向左旋转(0%- 49%):追求“更快、更硬”
不要把它当成“时间设置”,要把它当成“性格设置”。
- 人声旁白:直接保持 50%(Auto)。这是 Pro-Q 4 最强大的地方,它算得比你准。
- 低频乐器(贝斯/底鼓):尝试将 Attack 调至 60%-70%(稍慢),保留低频的“打击感”。
- 刺耳的高频(镲片/齿音):尝试将 Attack 调至 30%-40%(稍快),更精准地抓住刺耳的瞬间。
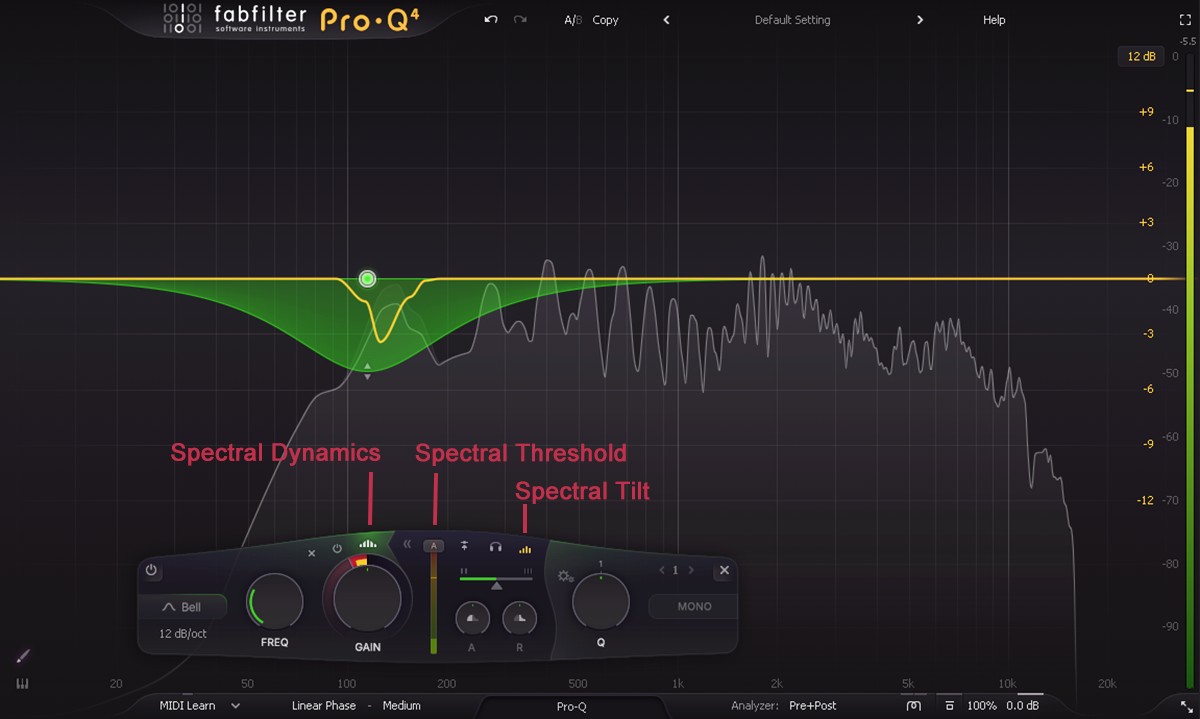
频谱动态(Spectral Dynamics)
与传统的动态 EQ 不同,它不依赖于音频信号的电平(Level)来触发压缩或扩展,而是根据频谱内容(Spectrum Content)来触发。
- Threshold:在 Spectral Dynamics 模式下,阈值并不决定“信号电平达到多少才开始工作”,而是作为一个灵敏度参考点,用于配合“频谱密度(Spectral Density)”来决定“什么样的频谱差异”会触发处理。
- 自动状态:默认值 Auto。阈值是自动设定的(显示为'A')。Pro-Q 4 会根据输入信号的频谱特性自动计算最佳的触发灵敏度,通常不需要手动干预。
- 手动模式:设定一个基准线。动态处理会根据当前频谱与这个基准线的差异来进行。
- 触发条件:结合 Spectral Density(频谱密度)参数,如果某个特定频率的能量“凸起”超过了由阈值设定的灵敏度范围,该频率就会被识别为需要处理的目标。
- 调高阈值(数值变大):会降低触发的灵敏度。这意味着只有那些非常明显、能量极高的“尖峰”频率才会被处理。适合处理非常强烈的、偶发的刺耳频率。
- 调低阈值(数值变小):会增加触发的灵敏度。这会让处理范围变宽,插件会去修正更多微小的频谱偏差。适合处理持续存在但幅度不大的共振峰。
- Spectral Density:频谱密度,控制处理的“选择性”。
- 低值:触发的频率范围较宽。
- 高值:触发的范围非常窄且精确,只针对特定的频率峰。
- 低密度+高阈值:触发范围宽但条件苛刻,适合处理大范围的、强烈的频率冲突。
- 高密度+低阈值:触发范围窄且非常灵敏,适合精准“切除”人声中细小的齿音或尖锐共振。
- Spectral Tilt:频谱倾斜。默认开启(On)。它会对输入频谱应用一个 3 dB/oct 的倾斜,使高频比低频更容易触发。这模拟了人耳的听感(粉噪特性),让处理结果听起来更自然,尤其是在处理全频段混音时。
- Attack & Release:启动与释放。控制动态变化的速度。
- 自动模式:中心位置(50%),代表自动模式,此时 Attack 和 Release 由插件根据输入音频的特性、当前处理的频率范围以及频谱密度设置,自动计算出最合适的 Attack 和 Release 曲线。
- 手动调整:向左(低数值)调快,向右(高数值)调慢。
- Attack:启动时间。控制插件识别并开始处理问题频率的速度。
- 逆时针旋转为更快(Fast):能瞬间捕捉到突然出现的刺耳频率(如瞬态噪声)。
- 顺时针旋转为更慢(Slow):会让处理延迟一点时间,通常用于避免处理掉声音的起振感(Attack),或者让某些瞬态通过。
- 由于 Spectral Dynamics 依赖线性相位处理,过快的 Attack(尤其是极快的设置)可能会引入预振铃(Pre-ringing)或相位伪影。除非你非常确定需要处理极短的瞬态,否则建议保持 Auto 或稍微偏慢的设置。
- Release:释放时间。控制插件在问题频率消失后,停止处理的速度。
- 逆时针旋转为更快(Fast):一旦问题频率消失,EQ 修正立即消失,适合处理断断续续的干扰音。
- 顺时针旋转为更慢(Slow):处理效果会持续一小段时间,适合处理频率缓慢变化的共振或混响尾音。
- Processing Resolution:处理分辨率。Spectral Dynamics 依赖线性相位(Linear Phase)处理。线性相位处理的精度(低、中、高),分辨率越高,低频处理越精确,但引入的延迟(Latency)也越大。
Linear Phase Resolution(分辨率):
| 档位 | 44.1kHz 采样率 | 总延迟时长 | 动态 EQ | 适用场景 |
| Low | 3072点 | 约 70 ms | 支持 | 仅用于低 Q 值设置,或只处理中高频。要求极低延迟的场景。 |
| Medium | 5120点 | 约 116 ms | 支持 | 官方推荐的通用档位,平衡低频分辨率与延迟,绝大多数线性相位处理场景都适用。 |
| High | 9216点 | 约 209 ms | 支持 | 低频要用高 Q 值处理时选它。 |
| Very High | 17408点 | 约 395 ms | 不支持 | 预振铃窗口,随分辨率升高而延长。离线母带可用。 |
| Maximum | 66560点 | 约 1509 ms | 不支持 | 代价是极大延迟与可能出现预振铃(pre-echo)问题。 |
分辨率档位越高,预振铃的时域分布越分散(单位时间幅度越低),但持续窗口同步变长,插件引入的固定延迟也同步增加。因此分辨率并不是"越高越干净",而是在频率精度与时间伪影之间做取舍。实时录音、实时监听场景建议优先用 Medium 档位,避免出现人声不同步的问题。
- 6~12 dB/oct 的低切用 Medium 就够。Medium 在 44.1 kHz 下的频域分辨率对 60 ~ 80 Hz 这种缓拐点绰绰有余,升到 Very High 没有可闻收益,只多付延迟与预振铃。
- 不要为"更彻底"去升档。真正决定"切得干不干净"的是频点与斜率,不是分辨率;想更陡应该加斜率或做多节点,而不是拉高分辨率。
- 需要高分辨率的只有一种场合:低频 + 高 Q 参量点(例如在 50 Hz 附近用 Q=3 做 6 ~ 10 dB 的窄衰减)。此时才值得升到 High / Very High。
- 低频低切,最小相位通常更安全。80 Hz 线性相位低切的预振铃恰好落在 80 Hz 附近——那是后向掩蔽最弱、人耳对低频时间伪影最敏感的区域;同频点的最小相位低切产生的是后振铃,会被瞬态本身掩蔽。线性相位的真正价值在多轨 / 并联时的相位对齐,而不是低频低切本身。
- 频率分辨率 ↔ 延迟 ↔ 预振铃长度"的三方取舍:档位越高,低频越准、延迟越大、预振铃越长。
手动调整 Attack、Release:针对人声的具体应用场景,虽然文档指出 Auto 模式通常是最好的,但在以下人声场景中,你可能需要手动微调 Attack 和 Release。
- 场景一:保留人声的“颗粒感”或“气口”
- 问题:你在处理人声的高频刺耳感(Harshness),但发现处理后人声变得太“平”了,失去了原本的质感和呼吸感。
- 调整:增加 Attack 时间(调慢),让处理延迟几毫秒开始。这样,人声起音瞬间的细微泛音(Transients)可以不受影响地通过,只有持续的刺耳共鸣被削减。
- 效果:既消除了刺耳感,又保留了人声的鲜活度。
- 场景二:处理持续的鼻音或共振
- 问题:人声在某个音节上有低中频的鼻音共振(Nasality),并且这个共振在音节结束后还持续了一小会儿。
- 调整:增加 Release 时间(调慢),让 EQ 的削减效果在人声结束后慢慢恢复。这可以确保整个共振尾音都被平滑地消除,而不会在声音结束的瞬间产生突兀的“抽吸”感(Pumping)。
- 场景三:处理突发的喷麦或爆音
- 问题:录音中偶尔有突然的低频喷麦声(Plosives)或衣服摩擦声。
- 调整:减小 Attack 时间(调快),确保能瞬间捕捉到这个突发的低频能量团。将 Release 设置得稍快,这样处理只在爆音发生的瞬间生效,爆音一结束立即恢复正常,不会影响后续的人声。
频谱动态(Spectral Dynamics)应用场景:
- 消除“刺耳感”与“齿音”(Harshness & Sibilance):
- 场景:人声在某些单词或音节(如“S”、“T”音)时,会在高频段(通常 4kHz - 8kHz 或更高)突然出现刺耳的声音,但整体电平并没有显著变大。
- 优势:传统动态 EQ 可能因为电平没达到阈值而不工作,或者为了处理齿音把整个高频都压下去。Spectral Dynamics 只要检测到那个特定的“刺耳”频率出现,就会瞬间将其削减,而不会影响该音节的其他部分。
- 处理“鼻音”或“共鸣峰”问题(Nasality/Resonances):
- 场景:人声在某些段落会有特定的低中频共鸣(例如 200Hz - 500Hz 的鼻音),这些频率并不是一直存在,而是随着歌词变化偶尔出现。
- 优势:你可以精准地针对那个偶尔出现的共振峰进行削减,而不需要像静态 EQ 那样一直把这段频率切掉,从而保留人声的厚度和温暖感。
- 去除录音环境中的“干扰音”:
- 场景:人声录音背景中有偶尔出现的特定频率噪音(如空调的特定啸叫、键盘敲击声的高频反射等)。
- 优势:它能像“频率吸尘器”一样,只吸走那些特定的干扰频率,而完全不影响人声主体。
区别
动态 EQ(Dynamic EQ)和频谱动态(Spectral Dynamics)区别:
- 动态均衡(Dynamic EQ):当触发信号超过阈值时,它会对选定的整个频段带宽,进行统一的增益提升或削减。
- 例如:3.5kHz,动态EQ,衰减 6 dB,当信号超过阈值时,会把这个整个频段的音量拉低。无论该频段内是 3.5kHz 还是 3.4kHz,只要触发了,它们都会一起被处理。
- 特点:处理的是宽频带。声音变化相对“整体”和“音乐化”。计算量较小,延迟极低。
- 频率追踪:无(固定频率处理)。
- 对音色影响:较明显,会改变该频段整体听感。
- 适用问题:整体浑浊、低频轰头、宽带齿音。
- 频谱动态(Spectral Dynamics):当触发信号超过阈值时,它只处理该频段内具体超过阈值的那个频率点(及其极窄的邻域),而保留该频段内其他未超阈值的频率不变。
- 例如:3.5kHz,频谱动态,衰减 6 dB,而只有 3.5kHz 处有一个刺耳的啸叫超过了阈值,Spectral 模式只会把 3.5kHz 切掉,而 3.4kHz 和 3.6kHz 的声音完全不受影响。
- 特点:处理的是极窄的频率点(即使你画的频段很宽)。极度精准,几乎不改变原始音色质感。计算量大,延迟较高。
- 频率追踪:有(可追踪移动的共振峰)。如果共振峰频率在移动(例如人声转音时的刺耳声),它能跟着移动并处理。
- 对音色影响:极小,几乎“隐形”,只去除问题点。
- 适用问题:尖锐共振、游走的啸叫、特定泛音刺耳。
选用【普通动态均衡】的情况:当你需要处理宽带的、整体的频率能量问题时。
- 去浑浊:
- 问题:男声在 300Hz-500Hz 整体听起来像闷在盒子里。
- 选择:普通动态。因为你需要降低整个中低频区域的能量,而不仅仅是某个点。
- 低频控制:
- 问题:贝斯或底鼓在 100Hz 以下太轰头,掩盖了其他乐器。
- 选择:普通动态。你需要在大动态时整体压低低频区。
- 宽带齿音:
- 问题:人声的"s"和"sh"音在整个 5kHz-8kHz 区域都太刺耳。
- 选择:普通动态。设置一个宽频段(Q=1.0),压缩整个高频区。
- 频率避让:
- 问题:人声出来时,背景音乐的整体高频需要让路。
- 选择:普通动态+外部侧链。
选用【频谱动态(Spectral)】的情况:当你需要处理尖锐的、窄带的、位置不固定的共振或噪音时。
- 游走的共振峰:
- 问题:歌手在唱高音时,某个特定的泛音(例如从 2k 滑到 2.5k)变得非常刺耳,但低音时正常。
- 选择:Spectral。普通动态无法追踪频率移动,要么切不掉,要么把不该切的也切了。Spectral 能跟着频率跑,只切那个刺耳的点。
- 吉他/弦乐的尖锐谐振:
- 问题:原声吉他拨弦时,琴体产生一个极窄的“嗡嗡”共振声,只在用力拨弦时出现。
- 选择:Spectral。它可以精准移除那个共振峰,同时保留吉他温暖的木质音色(普通动态可能会把木质音色也压暗)。
- 难以定位的刺耳声:
- 问题:你知道有刺耳声,但很难确定具体是哪个频率,因为它随音高变化。
- 选择:Spectral。画一个较宽的频段覆盖可能出现的范围,开启 Spectral 模式,它会自动“抓住”并处理那个超标的频率点。
- 保留音色的极端处理:
- 问题:需要大幅削减某个问题频率,但又不想让人听出明显的 EQ 痕迹。
- 选择:Spectral。由于它只处理超标部分,即使削减量很大(-20dB),听感上依然非常自然。
【Oeksound Soothe2】与 FabFilter Pro-Q 4 的频谱动态(Spectral Dynamics)异同:
- Soothe2:是“智能自动化”:适合快速修复、未知问题、复杂共振。它是当你不想思考具体频率,只想让声音变好听时的首选。它的算法在“自动发现”方面目前仍是行业标杆。
- Pro-Q 4 Spectral:是“手动精准化”:适合已知问题、多频段处理、高精度需求。它是当你已经听出了问题,想要像外科医生一样精准切除,且不希望有任何误伤时的首选。
最佳实践组合:
- 先用 Soothe2 挂在轨道前端,进行全局的、快速的共振平滑处理(设置较低的 Depth,只做轻微修饰)。
- 再用 Pro-Q 4 进行具体的静态 EQ 塑形,并对 Soothe2 没处理干净的、或者需要特殊动态控制的特定频段,开启 Spectral 模式进行精准打击。
【首选 Soothe2】
- “救火”场景:拿到一条录音质量很差的素材,到处都是嗡嗡声、盒状声、刺耳声,你没时间一个个去找频率。
操作:挂上 Soothe2,调大 Depth,瞬间平滑。 - 复杂游走的共振:例如电吉他solo时,随着音高变化,不同频率的共振峰不断出现,手动画 EQ 根本跟不上。
操作:Soothe2 的自动追踪算法在这种连续变化的场景下表现极佳。 - 人声去齿音/去嘶声的“懒人”方案:不想折腾 De-esser 的参数,只想快速让人声变顺滑。
操作:Soothe2 的高频段处理非常自然,通常只需调节一个旋钮。 - 创意效果:Soothe2 有一些独特的饱和度和混合(Mix)控制,适合用来做特殊的音色塑形。
【首选 Pro-Q 4 Spectral Dynamics】
- 精准手术:你明确知道问题在哪里(例如:男声在 350Hz 处有一个特定的喉音共振),且不希望影响 340Hz 或 360Hz 的音色。
操作:在 350Hz 画一个窄带,开启 Spectral,只切那个点。 - 多问题并行处理:同一条轨道上,既有低频的隆隆声(100Hz),又有中频的盒状声(400Hz),还有高频的刺耳声(6kHz)。
操作:在 Pro-Q 4 里开三个 Spectral 频段,分别处理,一个插件搞定。 - 需要外部侧链触发:你想用底鼓的信号去触发贝斯轨道上的某个特定频率的动态削减。
操作:Pro-Q 4 支持外部侧链+ Spectral 模式,Soothe2 不支持外部侧链触发其共振检测。 - 混音一致性要求极高:在母带处理或高精度混音中,你不希望算法“猜”哪里有问题,你需要完全掌控每一个被削减的频率点。
操作:使用 Pro-Q 4 的手动阈值和范围控制,确保处理的可重复性和精确性。 - CPU 资源紧张:不想加载多个重型插件。
操作:直接用 Pro-Q 4 代替“EQ + Soothe2”的组合。
处理模式(Processing Mode)
| 对比维度 | Zero Latency(零延迟) | Natural Phase(自然相位) | Linear Phase(线性相位) |
| 延迟表现 | 无延迟,实时处理 | 引入微量延迟(可忽略) | 明显延迟,分辨率越高延迟越大 |
| CPU占用 | 极低,适合多轨道 | 低-中等 | 较高,高分辨率时显著 |
| 幅度响应 | 接近模拟EQ,改进匹配 | 最精确模拟匹配,官方推荐 | 精确但不模拟模拟特征 |
| 相位行为 | 非常接近模拟 EQ,有相位偏移 | 相位最接近模拟EQ,自然 | 完全不改变相位,但有预振铃 |
| 预振铃(Pre-ring) | 无预振铃 | 无明显预振铃 | 有预振铃,影响瞬态 |
| 瞬态保留 | 完美保留 | 完美保留 | 预振铃模糊瞬态 |
| 动态频谱(Spectral Dynamics) | 不可用 | 不可用 | 强制启用线性相位 |
| 适用场景广度 | 录音/直播/实时监听 | 混音默认/全频段/人声 | 母带/M-S处理/相位校正 |
- Standard Minimum Phase Mode:标准最小相位模式。在给定幅度响应下,相位滞后最小、且幅度与相位通过希尔伯特变换唯一绑定的最小相位 EQ 处理方式。
- 优点:低延迟、CPU 低、瞬态保留完整。
- 延迟极低。没有线性相位那种明显处理延迟,适合录音监听、实时监听、直播链路。
- CPU 占用低。通常基于 IIR 滤波器实现,适合大量轨道使用。
- 瞬态保留好。脉冲响应能量集中在前面,鼓、打击乐、人声起音不容易被“糊化”。
- 听感自然。多数模拟 EQ 本身也是最小相位系统,所以这种处理方式最接近传统 EQ 听感。
- 适合常规混音。人声、乐器、总线塑形、日常减法 EQ 都可以优先使用。
- 缺点:相位偏移不可控。多个 EQ 串联时,容易产生相位累积和频率抵消。
- 相位偏移不可避免。只要改变幅度,就会伴随相位变化;斜率越陡、Q 越高,相位偏移越明显。
- 多 EQ 串联时相位会累积。多个最小相位 EQ 叠加后,整体相位响应可能变得更复杂。
- 可能产生频率抵消。在多轨、M/S 处理、立体声增强时,相位变化会影响左右或中侧关系。
- 不适合需要严格相位一致性的场景。比如,母带里需要避免多段处理造成的相位错位时,最小相位不是首选。
- 低频处理需要更谨慎。大斜率低频切/提时,相位偏移可能影响低频厚度或相位对齐。
- 优点:低延迟、CPU 低、瞬态保留完整。
- Zero Latency:零延迟模式。它的核心设计目标,是完全消除处理延迟、压低 CPU 占用,优先保证实时监听。它最接近标准最小相位,但是经过专门优化的,不属于标准定义下的最小相位模式。
- 它的幅频响应已经非常接近模拟 EQ,仅在 18kHz 以上极高频有微小偏差。
- 它的相位响应,既没有达到标准最小相位的理论状态,也没有像自然相位模式那样,精准复刻模拟EQ的相位曲线。
- 适用场景:录音监听、直播、低延迟监听、对延迟敏感的人声/乐器轨道。
- Natural Phase:自然相位。Pro‑Q 4 独有的相位模式。它不是标准最小相位,也不是线性相位,而是介于 Natural Phase(自然相位) 和 Linear Phase(线性相位)之间。
- 它“无预振铃”,但会引入少量延迟。
- 它幅度与相位响应,完全匹配模拟硬件 EQ,其听感更自然。
- 适用场景:全场景默认首选,尤其适配低频处理(低切)、高 Q 值的手术式精准均衡。人声旁白、合成器、母带前的精细塑形。
- Linear Phase:线性相位。只改变幅度,不改变相位。可避免相位抵消,但会引入延迟和预振铃(Pre-ring)。
- 预振铃(Pre-ring):这是线性相位最大的副作用。它会导致瞬态(如底鼓、军鼓的敲击声)在实际声音到达前产生微弱的“回声”或“模糊感”,使声音失去棱角。
- 延迟(Latency):线性相位会引入延迟,且分辨率越高,延迟越长。文档提供了不同分辨率的延迟参考。
- 适用场景:仅用于解决相位问题(母带、多 EQ 串联、M/S 处理),需要相位一致性的精细校正。避免用于鼓组等瞬态丰富的素材。
模拟 EQ 是“物理实现”,标准最小相位 EQ 是“数学/信号处理归类”;绝大多数模拟 EQ 的行为都属于最小相位系统,但并非所有模拟 EQ 都等于“理想标准最小相位”。
- 标准最小相位 EQ:是最理想状态的算法,相位响应严格遵循理论最小相位曲线。核心满足“所有零极点位于复平面左半侧、幅频特性与相频特性通过希尔伯特变换唯一绑定”的严格数学条件。
- Zero Latency:最接近“标准最小相位”行为,无额外延迟,适合监听和实时链路。
- Natural Phase:不是标准最小相位,也不是线性相位;它在幅度与相位上更接近模拟 EQ 的听感,但会引入少量延迟。
- Linear Phase:不是最小相位;它保持全频段相位关系一致,但会引入延迟和预振铃。
- 模拟 EQ:是基于模拟电路(电阻、电容、运算放大器等硬件)搭建的实体均衡设备。它改变幅度时,会自然伴随相位变化,而且这种相位变化通常不会让能量出现在主瞬态之前。
人声低切 80 Hz
TTS 男声旁白,基频多数在 100 ~ 120 Hz 之间,也有少数字的基频在 80 Hz。因此,在设置常用的人声低切 80 Hz 时,必须精准把握频率定义与滤波器的物理特性。
- Natural Phase:更接近模拟 EQ(最小相位行为)。低切人声基频时,会产生相位偏移,会产生相位失真。
- 若低切 80 Hz,12 dB/oct:
- 在 80 Hz 的截止点处,除了产生 3dB 的物理衰减外,还会引入 180° 的绝对相位旋转(相对于通带),且相位偏移会从远低于 80 Hz 的位置就开始逐步累积。这会直接改变人声基波与谐波的时间对齐关系。
- 如果素材里有 60–120 Hz 之间的能量(如混响尾音、房间感),它们会和剩余低频发生相位叠加或抵消,导致低频发空、发虚。
- 听感上就可能变成:低频变薄、发空、发虚、位置漂移,或者鼓点“变软”。
- 这尤其容易出现在电子人声、TTS 旁白这类素材上,因为它们的低频往往不是单纯的干净基频,而是包含合成器次低频、噪声底、混响尾音或房间感。
- 若低切 80 Hz,6 dB/oct:
- 80 Hz 截止点依然有 3dB 的物理衰减,但相位旋转被降低到 90°。过渡带极其平缓,最大限度地保留人声的温暖度,听感最为自然。相位畸变的可闻度直接降到几乎不可察。
- 同时还能完整滤除 80Hz 以下的次声底噪和震动杂音。
- 若低切 80 Hz,12 dB/oct:
- Linear Phase:无论何时,都不会产生相对相位偏移,都不会产生相位失真。
- 若低切 80 Hz,24 dB/oct:
- 预振铃表现:预振铃时长拉长到 8-12ms,已经达到人耳的可闻阈值,在所有爆破辅音的音头前,都会出现一层明显的微弱“回声模糊感”,直接把 TTS 人声原本锐利清晰的咬字抹软,旁白的清晰度大幅下降。
- 实际听感:低频分离度极高,没有多余的低频浑浊,但人声的瞬态棱角明显软化,听感上多出一层不自然的“朦胧感”,同时会引入更长的固定群延迟,实时监听场景必须额外做延迟补偿,否则会出现人声不同步的问题。
- 适配场景:仅适合极端多轨母带、需要严格全频段相位对齐的复杂混音场景,日常单人声旁白处理完全不推荐使用。
- 若低切 80 Hz,12 dB/oct:
- 预振铃表现:预振铃时长约 3-5ms,仅在处理 p、b 这类极强爆破辅音时,才会出现极其微弱的可闻模糊感,普通 TTS 旁白的常规咬字几乎完全感知不到。
- 实际听感:低频切割干净利落,同时全频段相位严格对齐,人声叠加 BGM 时不会出现低频相位抵消,整体通透度远好于同斜率的 Natural Phase 模式,不会出现叠加后低频发空的问题。
- 适配场景:带背景音乐的混音旁白、多轨叠加的有声作品,是兼顾多轨兼容性和听感的平衡选项。
- 若低切 80 Hz,6 dB/oct:
- 预振铃表现:预振铃时长被压缩到 2ms 以内,完全低于人耳的可闻阈值,哪怕是极强的爆破辅音,也完全感知不到任何提前的模糊感,人声的咬字瞬态棱角 100% 保留。
- 实际听感:极其顺滑自然,几乎没有任何人工处理痕迹,既能缓慢滤除 20-40Hz 的次声震动杂音,又能完整保留男声 80Hz 附近的低频基础厚度,人声温暖不干瘪。
- 适配场景:日常旁白、播客、有声书单人声处理,是兼顾干净度和自然度的最优解。
- 若低切 80 Hz,24 dB/oct:
低切的底层逻辑:截止频率的定义是该频率处衰减 3dB。
- 80 Hz 以上是通带,人声基频(80 ~ 120 Hz)要尽可能完整保留。低切频率绝不能直接设置在基频的最低点上,通常建议设置在 50Hz - 60Hz,或者在 80Hz 处使用极其平缓的斜率(如 6dB/oct)。
- 60 Hz 以下的次声、震动、底噪才是要彻底清除的目标,需要衰减 24dB 以上,才能做到听感上的“干净消失”。
- 低 Q 值:过渡带越平缓、滤波器 Q 值越低,时域过冲和相位失真就越小。
- 不要超过基频:若人声当中,有的字的基频在 80 Hz,当低切超过它之后,容易让基频的字失去胸腔支撑,听感上可能变成:个别字突然变薄;男声低频厚度不统一;旁白听起来“忽厚忽薄”。
FabFilter Pro-Q4 低切滤波器严格遵循行业标准的 -3dB 截止点定义。在 Linear Phase - Medium 模式下:
| 方案 | 120Hz | 80Hz | 60Hz | 50Hz | 40Hz | 30Hz |
单节点 80 Hz,12 dB/oct | -0.8dB | -3.0dB | -6.2dB | -8.8dB | -12.3dB | -17.1dB |
双节点 60Hz,12dB/oct + 80Hz,6dB/oct | -1.9dB | -4.2dB | -7.4dB | -10.4dB | -14.8dB | -21.4dB |
双节点 60Hz,12dB/oct + 75Hz,6dB/oct | -1.7dB | -3.9dB | -7.1dB | -10.0dB | -14.4dB | -20.9dB |
双节点 60 Hz,12 dB/oct + 70 Hz,6 dB/oct | -1.5dB | -3.7dB | -6.7dB | -9.6dB | -13.9dB | -20.4dB |
双节点 60 Hz,12 dB/oct + 65 Hz,6 dB/oct | -1.4dB | -3.4dB | -6.4dB | -9.2dB | -13.4dB | -19.9dB |
TTS 人声旁白,在完全不引入相对相位偏移失真的前提下,把 80Hz 以下无用低频彻底清干净的最佳方案,是“双节点低切分法”,来解决单节点 12dB/oct 低切切不干净的问题。
Linear Phase - Medium 模式,双节点低切方案:
- 第一个低切点:设置 60Hz、12dB/oct,先把 50Hz 以下的次声震动、底噪完全滤除,这部分完全不涉及人声有效能量,不会对 80Hz 附近的人声基波产生任何干扰。
- 第二个低切点:设置 75Hz、6dB/oct,能把 80Hz 以下的无用低频彻底切除干净,同时过渡带比单节点直接拉 24dB/oct 平缓很多。
- 顽固低频处理:如果 80Hz 以下还有极个别峰值能量的顽固低频杂音,不需要再拉高低切斜率。直接在 Linear Phase 模式下,用一个 Q = 3.0 的参量点,在杂音的峰值频率位置做 6 ~ 10dB 的衰减。
- 注意隐性代价:链路断裂——若后续还要使用 Wavesfactory Equalizer 等最小相位的处理器,会随音频实时引入频段相关的相位变化。前面的相位对齐努力会被完全冲掉,等于白承担预振铃的代价。
此方案的优点:
- 人声友好度:120 Hz 仅衰减 1.3dB,完全保留 100 ~ 120Hz 核心基波能量,80Hz 仅衰减 3.2dB,不会误伤偶发落在 80 Hz 的字的基频。
- 清洁度达标:30 Hz衰减 19.5dB,彻底清除次声震动、喷麦和近讲效应残留,完全解决单节点 12dB/oct 切不干净的问题。
- 副作用极低:Medium 分辨率下预振铃时长控制在 5 ms 以内,完全低于 TTS 人声的可闻阈值,不会破坏咬字清晰度。
经过测试,在 Natural Phase 模式,上述设置,仍然会相位失真。