Waves 插件2
| PlaylistRider Mono PlayistRider Stereo | 广电或直播使用的音量统一动态控制插件 |
| Vocal Rider Live Mono Vocal Rider Live Stereo Vocal Rider Mono Vocal Rider Stereo | 专为人声优化的自动电平推子 |
| Bass Rider Live Mono Bass Rider Live Stereo Bass Rider Mono Bass Rider Stereo | 针对贝斯声部设计的专用电平推子 |
PlaylistRider
Waves PlaylistRider:实时自动音量调节插件(Real-Time Automatic Volume Rider),用于自动、连续地调整多个音频源的增益,使音量保持一致,无需人工手动推拉推子。
解决什么问题:在现场演出或广播中,音频工程师需要将不同来源(如电脑、视频源等)接入调音台。这些不同来源的音频电平差异很大且难以预测,工程师必须实时手动推拉推子来维持电平稳定——这既紧张又容易影响演出效果。Playlist Rider 的作用就是自动完成这项工作,像一位工程师在实时操控推子一样,自动将各音源调整到指定目标电平,让工程师少操一份心。
- 核心功能:
- 自动电平匹配:将音频源自动调整到用户指定的目标电平(Target Level),以非破坏性方式处理。可设置输入阈值(Detector Threshold),低于该阈值的低音量音频(如歌曲淡出部分)不会被处理。
- 音色均衡:开启后,将音源音频缓慢匹配到粉色音色曲线(Pink tonal curve),平滑不同音源之间的音色差异,提升整场演出的声音一致性。
- 实时感知响度检测:使用短期(Short-term)和长期(Long-term)两种检测器,基于人耳感知的响度来计算增益调整。多音源在插件内部链路上的动态计算,实现基于感知响度的自动增益。
- 适用场景:
- 现场演出:自动匹配不同音源的电平,减轻工程师负担。
- 广播制作:确保节目各段音量一致。
- 播客/直播/内容创作:自动平衡主持人、嘉宾、背景音乐、音频片段等多路音源的音量,实现整场自然一致的响度。
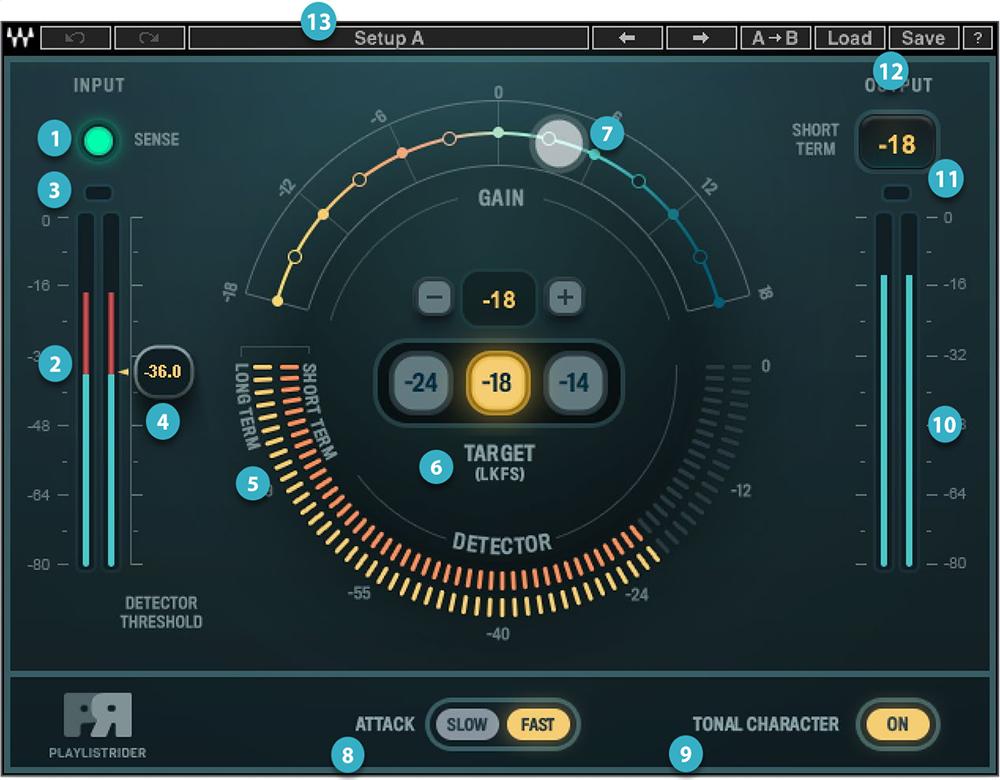
界面控件说明:
- 1、Sense Light:设置最佳输入电平。绿灯=最优,黄灯=输入过高,红灯=过高到无法处理,无灯=输入过低。
- 2、Realtime Input Meter:实时显示输入音频的峰值电平。
- 3、Input/Output Peak LED:当输入或输出电平过高时红灯亮起,点击可重置。
- 4、Detector Threshold:设定阈值,低于该阈值的信号不会被检测和处理;采用软拐点曲线,增益过渡渐进自然。
- 5、Short/Long-Term Detector Meters:显示短期和长期感知响度。
- 6、Target(LKFS):用于设定音频源的目标电平值。LKFS是衡量感知响度的标准单位,它不是简单的峰值测量,而是基于人耳对声音的感知来评估平均响度,比传统的 dBFS 更能反映实际听感。
- -14 dB:较 loud,适合需要突出音量、能量感强的场景。
- -18 dB:平均电平,适合大多数常规演出和广播场景。
- -24 dB:较柔和,适合安静、细腻的音频内容。
- 7、Gain Ball:动态指示器,实时显示插件根据感知输入响度和 Target 设置所做的增益调整量。它相当于一个"可视化反馈",让你直观地看到插件正在对音频做多大的增益补偿。
- 在调整 Target 和输入增益时,观察 Gain Ball 的动态变化,确认插件的增益调整幅度是否合理。
- 如果 Gain Ball 的摆动幅度过大,说明音频源之间的响度差异过大,需要分别调整各输入通道的增益。
- 理想状态下,Gain Ball 应在小范围内温和摆动,表明插件正在平滑地进行电平匹配。
- 8、Attack:控制插件对输入变化的反应速度,即插件多快对音频电平的变动做出增益调整。它直接影响增益过渡的自然程度和响应灵敏度。
- Fast(快速):反应迅速,能紧跟音频电平的变化。适合场景:动态变化剧烈的音频,如摇滚现场、节奏感强的内容。
- Slow(慢速):过渡更平滑,增益变化更渐进。适合场景:需要自然过渡的场景,如古典音乐、播客口播、环境氛围音。
- 音频源之间的电平切换频繁且需要快速响应时,选择 Fast。
- 当希望增益过渡更加平滑自然、避免"抽吸感"时,选择 Slow。
- 在现场演出中,可以根据节目类型灵活切换:快节奏段落用 Fast,慢节奏段落用 Slow。
- 如果不确定如何选择,Slow 是更安全的默认选择,因为它能提供更自然的听感,避免增益调整过于突兀。
- 9、Tonal Character:开启后会将音频源缓慢匹配到粉色音色曲线(Pink tonal curve),从而平滑不同音源之间的音色差异。
- 不同的音频源(如电脑播放的视频、手机播放的音乐、现场麦克风)由于录制设备和编码方式的差异,音色特性各不相同。
- 开启 Tonal Character 后,插件会实时对音频进行音色归一化处理,将各音源的频谱特征缓慢地向粉色音色曲线靠拢。
- 这种匹配是"gentle and slow"(温和且缓慢)的,不会造成明显的音色失真。
- 在以下场景建议开启:
- 多个音源混用,且各音源音色差异明显(如电脑视频+手机录音+现场麦克风)。
- 需要整场演出声音一致性高的广播或直播节目。
- 在以下场景建议关闭:
- 单个音源,无需音色匹配。
- 对音色保真度要求极高的专业录音场景。
- 音源本身音色已经比较统一的情况。
- 建议在实际演出前先试听开启前后的效果差异。Tonal Character 的处理是实时的,可以在演出过程中随时开关,根据节目需要进行灵活调整。。
- 10、Output Short Term Display:以 LKFS 显示处理后的短期输出结果。
注意事项:
- 插件内部限制器不是前置监听(look ahead)类型,提供零延迟运行。
- 输出短期显示值与 Waves Loudness Meter 的短期测量(Method = LM1, Short Time = 400ms)接近但不完全一致,偏差±1 dB 在可接受范围内。
典型使用流程:
- 将多个节目输入通道(如电脑、视频源)路由到一个立体声组。
- 在该组上插入 Playlist Rider 插件。
- 设置目标电平(Target Level):-18 dB 为平均电平,-14 dB 为较 loud,-24 dB 为较柔和。
- 决定是否开启音色均衡(Tonal Character)。
- 逐个播放音频源,调整各输入通道的增益,使 Sense 指示灯主要显示绿色。
- 如有需要,调整 Detector Threshold 以避免处理淡入淡出部分。
Vocal Rider
Waves Vocal Rider:人声推子。自动跟踪并调节人声轨道的电平,无需手动推拉调音台推子,也无需在 DAW 中逐段绘制电平变化曲线。只需设定人声电平相对于整体混音的目标范围,插件便会实时自动调整人声音量,使其始终保持在设定的目标区间内。与压缩器不同,Vocal Rider 不会给人声轨道添加任何额外的音色染色,它只做纯粹的电平跟踪与调节,因此能够保持人声原有的声音特质不变。
核心优势:
- 自动保持人声电平一致:无需人工干预,实时自动调节人声音量,确保整首歌曲中人声电平稳定一致。
- 不改变声音音色:与压缩器不同,Vocal Rider 不会对信号进行动态处理染色,保持人声原始音质。
- 适用场景广泛:从录音棚到演唱会现场,从广播工作室到后期制作棚,Vocal Rider 都能发挥出色表现。
- 节省混音时间:省去手动推拉推子或绘制自动化曲线的繁琐工作,大幅提升混音效率。
Vocal Rider 将混音元素分为两个主要部分进行处理:
- Vocal(人声):所有包含人声的轨道,无论是否挂载了效果器(由用户定义)。
- Music(伴奏):除人声轨道以外的所有混音元素,即整体伴奏。
Vocal Rider 通过侧链(Sidechain)监听伴奏信号,实时分析人声与伴奏之间的电平关系,从而智能地调整人声推子位置。
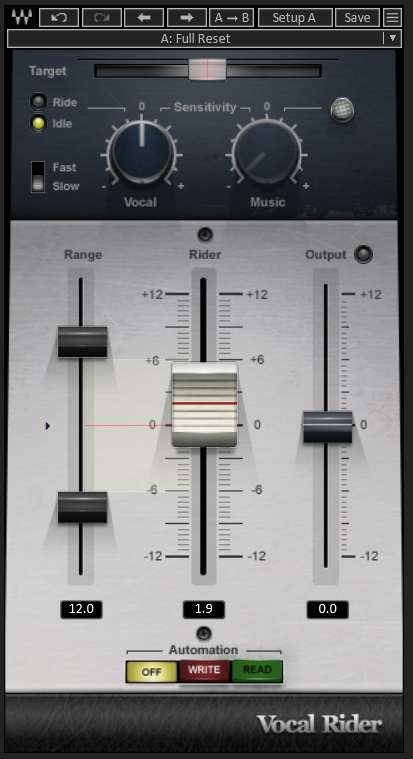
- Target:目标电平。设置人声混音定位的参考范围。插件以此为基准,自动调整增益使实际电平趋近该目标。范围:0 到 -42 dBFS。默认值:-21 dBFS。
- Target 对应的是,人声在正常演唱时,所在的电平范围,而非瞬态峰值(transient peak)。
- dBFS 是数字音频领域的标准电平单位,0 dBFS 对应数字系统的最大不失真电平。
- 在数字混音中,人声在混音中的典型电平通常位于-20 到 -15 dBFS 之间。默认值:-21 dBFS,是一个默认起始值,实际使用中必须根据具体素材调整。
- 调整该参数,会重置 Rider 推子的“0值”校准,重新对齐目标电平区间。
- Spill:用于区分人声信号和多余的舞台环境噪声,提升追踪精准度。(仅限 Vocal Rider Live 组件)。范围:-12 到 -48 dBFS。默认值:-48 dBFS。
- 使用方法:在现场演出中,如果伴奏停止时 Rider Fader 仍在移动(说明检测到了舞台环境噪音),则调整 Spill 控制来过滤这些不需要的信号,使人声跟踪更精准。
- Vocal Sensitivity:人声灵敏度。控制人声检测器的灵敏度,用于区分人声内容与底噪、溢出声和环境声,并识别人声单词的起始和结束。范围:±12 dB。默认值:0。
- 值越高,越容易把低电平语音(如气声、尾音)识别为人声;值过低可能忽略弱音。
- 使用方法:提高灵敏度可以检测更微弱的人声;降低灵敏度则只响应较强的人声信号。需要根据人声演唱的动态特点进行微调。
- Vocal Activity Display:指示灯,用于显示是否检测到有效人声活动。当无人声时显示 Idle,有人声时显示 Ride。
- Attack:响应速度。设定人声检测的启动行为,同时影响检测时间和推子移动速度。
- Slow:默认值。过渡更平滑自然,适合大多数常规场景。适合抒情演唱。
- Fast:反应更迅速,适合人声动态变化剧烈的场景。适合节奏快、瞬态强的演唱。
- Music Sensitivity:伴奏灵敏度。需启用侧链输入。当伴奏变响时,Vocal Rider 可自动微调人声音量以保持相对平衡(类似智能 Ducking)。LED 亮度反映其活跃程度。范围:±12 dB。默认值:0。
- 重要前提:必须将伴奏混音总线分配到 Vocal Rider 的侧链输入端才能使用此功能。
- 使用方法:提高此值后,当伴奏音量变大时,Vocal Rider 会自动提升人声电平以匹配;伴奏变小时则降低人声电平。
- Music Sensitivity LED:伴奏灵敏度指示灯。从柔绿到亮绿,LED 越亮表示人声 Riding 越受伴奏电平影响。
- Range Min:下限边界。设定 Rider Fader 移动范围的下限,即 Rider 推子最大衰减量。范围:-12 到+11 dB。默认值:-6 dB。
- Range Max:上限边界。功能:设定 Rider Fader 移动范围的上限,即 Rider 推子最大增益量。范围:-11 到+12 dB。默认值:+6 dB。
- Effective Range:有效范围。显示自动 Riding 可用的总增益范围。由 Range Max 和 Range Min 共同决定,表示 Rider Fader 可以上下移动的总范围。
- Rider Fader:自动推子。是 Vocal Rider 的核心自动控制器,根据内部检测器算法自动移动,实现人声电平的自动化调节,类似于手动推拉推子。范围:-12 到+12 dB。
- 说明:Target 控制用于设定 Rider Fader 的"0"校准点。
- 用鼠标拖动推子,可临时手动调整增益,松开后将自动恢复自动推控;使用控制台手动覆盖时,按下控制台的 Manual 按钮,即可手动覆盖。
- Automation Mode:自动化模式。控制 Rider Fader 的操作模式。
- Off(关闭):Rider Fader 使用内部引擎,不发送也不读取自动化数据(默认)。
- Write(写入):所有 Rider Fader 的移动都被发送到宿主应用的自动化轨道。宿主需启用写入/触摸/保持模式的自动化。
- Read(读取):Rider Fader 使用自动化轨道来定义其移动,忽略 Vocal Rider 的内部引擎。
- 使用方法:先切换到 Write 模式录制自动 riding 数据,之后可切换到 Read 模式回放编辑后的自动化曲线进行微调。
- Output:输出增益。在自动 riding 之后对人声输出增益进行微调。CLIP LED 在输出削波时亮起。范围:-12 到+11 dB。默认值:0 dB。
快速上手
信号链顺序:
录音 → 拼接(comping)→ 混音定位 → 音色调整(动态/EQ/效果) → 电平跟踪(Vocal Rider) → 输出。
它是最后一步,通过对播放电平做更精细的小幅调整,让人声在整首歌中的位置保持一致。
快速上手流程:
- 插入插件:将 Vocal Rider 作为最后一个效果器插入到人声轨道或人声组合轨道。
- 设置侧链:将伴奏轨道 Post-Fader 发送到辅助总线,并在 Vocal Rider 中将该总线分配为侧链输入。
- 初始调试:开始播放歌曲,调整 Vocal Sensitivity(人声灵敏度) 和 Attack 参数。
- 设定目标:移动 Target 透明屏幕到 Vocal 范围峰值位置,设定人声目标电平。
- 观察效果:电平推子将开始自动移动,实时平衡人声电平。
- 现场优化:在现场模式下,如果无人声时推子仍有移动,调整 Spill 参数以区分环境噪声。
- 限制范围:通过设置 Range 上下限来限制自动增益变化的幅度。
- 伴奏联动:调整 Music Sensitivity 使伴奏与人声电平联动。
- 自动化录制:启用 DAW 自动化录制,按 Automation Write 键录制推子运动,之后可按 Read 模式回放并手动微调。
- 最终输出:用耳朵监听,通过 OUTPUT 推子进行最终电平匹配。
人声峰值 -6 dBFS 时 Target 怎么设:不要对准峰值,应设在人声典型演唱电平(约 -15 到 -12 dBFS),然后通过观察 Rider Fader 摆动来微调。
- 第一步:当 Attack 设置为 Fast,将 Target 初始设在 -15 dBFS 左右。当 Attack 设置为 Slow,将 Target 初始设在 -21 dBFS 左右。
- 第二步:播放歌曲,观察 Rider Fader 的摆动情况。
- 第三步:如果 Rider Fader 大部分时间在 0 以上(一直在提升),人声听起来被过度提升了,说明 Target 设高了,往下调。
- 第四步:如果 Rider Fader 大部分时间在 0 以下(一直在衰减),人声听起来被压低了,说明 Target 设低了,往上调。
- 第五步:理想状态:Rider Fader 在 0 附近小幅对称摆动,说明 Target 位置合适。
预设
- Default Preset:Target:-21 dBFS;Vocal Sensitivity:0 dB;Attack:Slow;Range Min:-6 dB;Range Max:+6 dB;Output:0 dB。
- Smooth Ride:Target:-23 dBFS;Vocal Sensitivity:0 dB;Attack:Slow;Range Min:-2 dB;Range Max:+2 dB;Output:0 dB。
- Moderate Riding:Target:-13.1 dBFS;Vocal Sensitivity:0 dB;Attack:Slow;Range Min:-2.6 dB;Range Max:+6.1 dB;Output:+0.1 dB。
- Fast Rider:Target:-14.2 dBFS;Vocal Sensitivity:0 dB;Attack:Fast;Range Min:-3 dB;Range Max:+3 dB;Output:0 dB。
- Low Rider:Target:-30 dBFS;Vocal Sensitivity:0 dB;Attack:Fast;Range Min:-12 dB;Range Max:+0 dB;Output:0 dB。
- High Rider:Target:-17 dBFS;Vocal Sensitivity:0 dB;Attack:Fast;Range Min:-6 dB;Range Max:+8 dB;Output:0 dB。
- Rocky Ride:Target:-42 dBFS;Vocal Sensitivity:+12 dB;Attack:Fast;Range Min:-8.4 dB;Range Max:+7.4 dB;Output:+3.8 dB。
- Loud Riding:Target:-10.5 dBFS;Vocal Sensitivity:0 dB;Attack:Fast;Range Min:-3.3 dB;Range Max:+8.7 dB;Output:+0.1 dB。
- Loud Vocal:Target:-10.5 dBFS;Vocal Sensitivity:0 dB;Attack:Fast;Range Min:-2.6 dB;Range Max:+6.1 dB;Output:+0.1 dB。
- Auto VCA:Target:-21.8 dBFS;Vocal Sensitivity:+3.7 dB;Attack:Fast;Range Min:-4.9 dB;Range Max:+3.6 dB;Output:0 dB。
- Smart Attenuator:Target:-21 dBFS;Vocal Sensitivity:+12 dB;Attack:Fast;Range Min:-10.5 dB;Range Max:+0 dB;Output:0 dB。
- Hard Limit Riding:Target:-42 dBFS;Vocal Sensitivity:-12 dB;Attack:Fast;Range Min:-12 dB;Range Max:+0 dB;Output:+4.2 dB。
- De-Compression:Target:-21 dBFS;Vocal Sensitivity:0 dB;Attack:Slow;Range Min:-12 dB;Range Max:+12 dB;Output:0 dB。
TTS 人声
TTS 人声 动态特点是,整体音量电平稳定,只是一句话内某个字存在忽大忽小的变化,是突兀性的。字与字之间的电平跳变非常突兀、不自然(TTS 合成时每个音节的增益分配不完全均匀)。没有自然呼吸和动态起伏,问题集中在音节级别的电平不均,Waves Vocal Rider 不是最佳工具,它只是可以缓解 TTS 人声句内"忽大忽小"的问题。它的设计目标是语段级(句子之间、主歌与副歌之间)的电平统一,而不是字级(150–300 ms)的瞬间补偿。所以它天生是"管句子"的,不是"管字"的。
Vocal Rider 模拟录音师手动推推子,动作刻意做得平滑、面向乐句与段落,把整条人声的音量曲线拉平。它本质上是一个自动推子(Auto Fader),它的检测算法是针对自然人声演唱/朗诵的动态特征优化的——人声有自然的起音、 sustain、释音过程,检测器会有一定的"惯性"。Attack 只有 Fast / Slow 两档,本质是较慢的整体增益跟随;它改变的是「推子位置(整条人声的整体增益)」,不压缩字内部、瞬时的动态。所以当一句话里某个字突然很轻、紧接着又恢复(毫秒到百毫秒级的局部凹陷),它的反应往往跟不上;硬把 Range 开大又容易让整句被推得忽上忽下、不自然。有混音师就明确提到:遇到「某个字突然很响、随即变轻」这类突然跳变,Vocal Rider 速度跟不上,仍需手动补救。对 TTS 这种干净素材,逐字把偏小的字单独抬 2–4 dB(clip gain)才是最精准、最自然的解法。
Waves Vocal Rider、Waves MaxxVolume 两者本质都是整段电平管理工具,用它去修句子里的单字,都是用大锤敲绣花针。
- 如果偏小的字是"孤立、短促、突然跳出来"的:
- 两者都不理想。最佳用 clip gain。
- Vocal Rider 跟不上这种速度。
- MaxxVolume 的向上压缩虽快,但会把句中所有低于阈值的内容(字间停顿、换气、气口)一并抬起来,TTS 上容易出现"呼吸声被放大、字与字之间发糊"。
- 如果整句是"缓和、持续"的电平起伏(例如一整半句偏轻):
- Vocal Rider 更合适。它透明、无染色,且能写入自动化后把那几个字单独再手推一下。
- MaxxVolume 做不到这点,是它在本场景里的决定性优势。
- 如果偏小的字很多、分布均匀,需要更强的"即时响应":
- MaxxVolume 的低电平压缩在响应速度上更有优势,但要严格克制增益并警惕噪声。
- 总体上 Vocal Rider 更稳妥。
Vocal Rider 设置:
- Target:设在整段 TTS 的平均电平附近(例如 -18dB 左右),作为基准参考点。
- Range Max:提升上限,设为 +3 ~ +6dB。这是处理偏小字的主力参数,可根据最弱那个字的差距适度放大。
- Range Min:衰减下限,设为 -1 ~ -3dB 即可。TTS 通常不需要大幅压低大声字,设得太低反而会拖累正常字的响度。
- Attack:选择 Fast。因为字级跳变发生在几十到几百毫秒内,Slow 模式的渐变速度跟不上。
- Vocal Sensitivity:适度调高,确保插件能识别到弱读的字;但如果出现推子乱动或误触底噪的情况,就稍微回调一点。
- Idle Arrow:保持在中间值,避免字与字之间出现明显的增益跳跃。
Vocal Rider Fast 模式,能帮你"大致抹平"TTS 句内的忽大忽小,但如果追求精细均匀,压缩器才是这个场景下的主力工具。
- 压缩器(Compressor)—— 首选
- 阈值(Threshold)设在偏小字的电平附近。
- 压缩比(Ratio)设为 2:1 ~ 4:1。
- Attack 设快一些捕捉音节起音。
- Release 设适中让补偿自然。
- 效果:直接压大动态范围,让小声字被拉上来、大声字被压下去。
- 多段压缩器(Multiband Compressor):如果 TTS 的问题是某些频率范围的字特别不均匀,可以分段处理,更精细。
- 手动自动化(Manual Automation)—— 最精准。在 DAW 中逐字绘制音量包络线,最费时间但控制最精确。